n8n in productie: 7 dingen die je automatisering mist
Ergens in de afgelopen 2 jaar is een workflow in je bedrijf opgehouden een handigheidje te zijn en infrastructuur geworden. Niemand heeft iets getekend. Er was geen livegang. Iemand van operations bouwde het ding op een dinsdag om zichzelf een uur werk te besparen, en nu lopen er 180 klantorders per dag doorheen.
De vraag die de meeste teams stellen zodra ze over n8n in productie gaan nadenken, is of n8n zelf productieklaar is. Dat is de verkeerde vraag, en daarom lopen die gesprekken zo vaak dood. n8n is serieuze software die bij genoeg bedrijven op echte schaal draait. Jouw workflow is het deel dat waarschijnlijk niet productieklaar is, en dat gat is niet technisch. Niemand heeft ooit besloten dat het ding productie was, dus zijn de beslissingen die bij dat woord horen ook nooit genomen.
Dit artikel is geschreven voor oprichters, CTO's en operations-managers bij bedrijven van ruwweg 20 tot 250 mensen, waar automatiseringen al aan orders, facturen, salarisbetalingen of klantgegevens zitten. Sta je nog tools te vergelijken voor een eerste pilot, dan is dit te vroeg voor je. Heb je een workflow die voor een vervelende ochtend zorgt als hij stilvalt, of erger, als hij blijft draaien terwijl hij fout zit, dan ben je hier goed.
Je leert hoe je ziet dat een automatisering stilletjes is gepromoveerd tot productie, welke 7 eigenschappen hij daarna nodig heeft, hoe je kiest tussen in n8n houden, opsplitsen of herbouwen, en hoe die keuze eruitziet met echte cijfers op een echt proces.
Belangrijkste punten
• n8n in productie is eerst een organisatievraagstuk en pas daarna een infrastructuurvraagstuk. Queue mode geeft je workflow geen eigenaar.
• Een workflow is productiesoftware zodra hij naar een bronsysteem schrijft, iemand buiten de bouwer ervan afhankelijk is, of een fout resultaat geld of vertrouwen kost.
• Het gevaarlijke falen is niet de rode uitvoering. Het is de groene die het verkeerde deed, en daar kijkt je monitoring niet naar.
• Herhaalveiligheid is het duurste om achteraf in te bouwen. Een workflow twee keer draaien mag nooit twee keer een factuur betalen.
• Het standaardantwoord is geen herbouw. Meestal is opsplitsen beter: n8n houdt de bedrading, een kleine dienst van jezelf doet de schrijfactie met gevolgen.
• Herbouwen doe je als volume, complexiteit, auditeisen en wijzigingsfrequentie dezelfde kant op wijzen. Dat zijn meestal 2 of 3 signalen, niet 1.
• Documentatie is hier geen bureaucratie. Een kritieke workflow zonder documentatie is een enkel faalpunt met de naam van een persoon erop.
Wat n8n in productie echt betekent
Een automatisering staat in productie op het moment dat iemand die hem niet gebouwd heeft afhankelijk is van de uitkomst en een fout resultaat geld kost. Dat is de hele definitie. Het heeft niets te maken met waar hij draait, of je het cloudabonnement betaalt, of hoeveel nodes erin zitten.
Dat is belangrijk, want het woord productie brengt verplichtingen mee die teams automatisch op software toepassen en bijna nooit op workflows. Als je engineers een feature opleveren, hoeft niemand te pleiten voor code review, een testomgeving, een piketdienst of een terugrolplan. Die dingen horen bij de categorie. Een workflow die iemand van finance in een visuele editor bouwde, komt met niets daarvan, en dat gemis is onzichtbaar, want het ding werkt gewoon.
Er is nog een tweede verwarring om op te ruimen. Dat n8n productiewaardig is en dat jouw workflow productiewaardig is, zijn twee losse beweringen. Het platform kan je belasting prima aan terwijl jouw specifieke workflow één hernoemd veld verwijderd is van het stilletjes laten vallen van elke derde order. Leveranciers beantwoorden de eerste bewering. De tweede beantwoordt niemand voor je.
We zien dit patroon voortdurend als we gevraagd worden naar een automatiseringslandschap te kijken. De infrastructuur is meestal in orde. Wat ontbreekt is eigenaarschap, foutafhandeling en enige manier om het verschil te zien tussen een workflow die gedraaid heeft en een workflow die klopte.
Het promotiemoment waar niemand bij is
Workflows worden zonder vergadering gepromoveerd tot productie. Er zijn 3 grenzen, en de eerste die je passeert is de grens die telt.
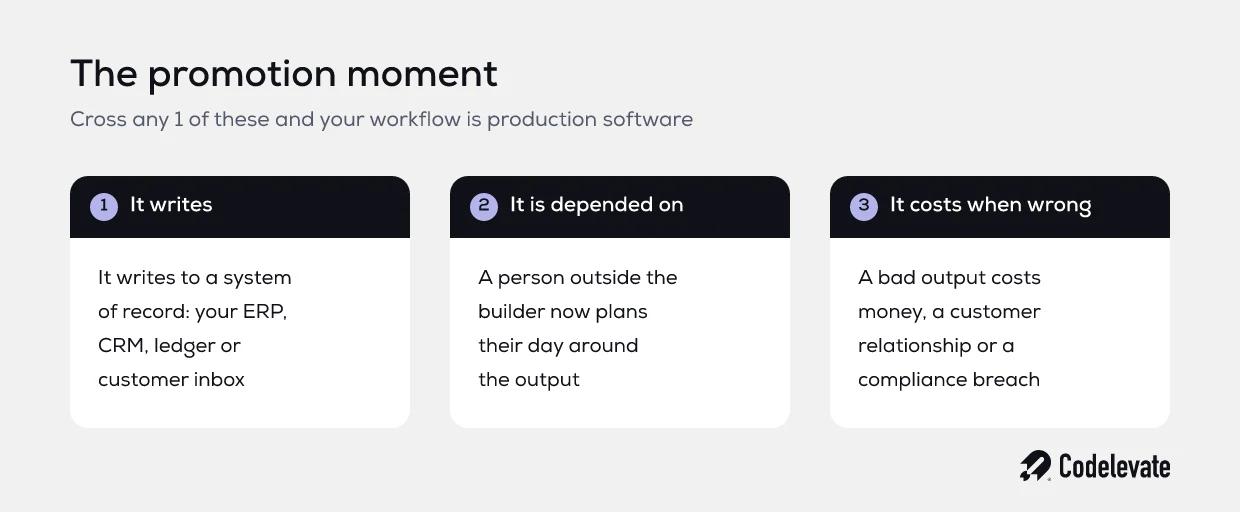
• Hij schrijft. De workflow leest en meldt niet alleen meer, hij maakt of wijzigt records in een bronsysteem: je ERP, je CRM, je grootboek, je klantmailbox.
• Er leunt iemand op. Iemand buiten de bouwer plant zijn dag rond de uitkomst en doet de handmatige variant al maanden niet meer.
• Fout kost geld. Een verkeerde uitkomst betekent geld dat fout is geboekt, een klant die iets onwaars te horen kreeg, of een verplichting die is gemist.
De nuttige oefening kost 20 minuten. Zet elke automatisering die je draait op een rij en markeer welke van de 3 grenzen hij gepasseerd is. De meeste teams schrikken twee keer. Eerst van hoeveel workflows minstens 1 grens over zijn. Daarna van hoeveel daarvan gebouwd zijn door iemand die inmiddels een andere rol heeft, of weg is.
Waarom automatiseringen stil falen
Dit is het faalpatroon waar je je zorgen over moet maken, en het is niet het patroon waar mensen op voorbereid zijn.
Een workflow die crasht is een goede storing. Hij is luid, hij kleurt rood in de uitvoeringslijst, iemand krijgt een melding en het probleem is binnen minuten zichtbaar. De dure storing is de workflow die netjes slaagt en het verkeerde doet. Elke uitvoering is groen. Het dashboard is schoon. En 11 dagen lang zijn er inkooporders aangemaakt op de verkeerde leverancier, omdat een bovenliggend systeem de leverancierscode opeens in een ander veld teruggeeft.
Het loont om de vormen hiervan te kennen, want zodra je ze kunt benoemen ga je ze zien:
• Een API geeft HTTP 200 terug met een body waarin staat dat de actie geweigerd is. De node is tevreden. Het record is nooit weggeschreven.
• Een veld wordt hernoemd, dus een filternode matcht niets meer. Er stromen nul items door, en nul items is geen fout.
• Een modelnode geeft vloeiende, plausibele, onjuiste uitvoer. Er is geen exception om op te vangen, want technisch is er niets misgegaan.
• Een retry draait een stap die al geslaagd was, en er gaat een tweede factuur naar dezelfde klant.
• Een rate limit geeft een halve pagina resultaten terug, en de workflow verwerkt 50 van de 200 records alsof dat alles was.
Al die gevallen zijn geslaagde uitvoeringen. Dit is het gat tussen monitoring, die kijkt of de workflow gedraaid heeft, en zicht op uitkomsten, dat kijkt of het bedrijf het juiste resultaat kreeg. Bijna niemand bouwt dat tweede, en daarom worden deze problemen meestal ontdekt door een klant of een boekhouder in plaats van door een systeem.
Als je aan het uitzoeken bent waar automatisering en AI in jouw operatie echt iets opleveren, laat onze SaaS AI Blueprint zien hoe je dit soort werk zo afbakent dat het echt volume overleeft. Hij is gratis en geschreven voor degene die het budget moet verdedigen.
7 dingen die je n8n-workflow mist
Dit zijn de eigenschappen die een slimme workflow van productiesoftware scheiden. Geen daarvan dwingt je om n8n te verlaten. Alle zeven vragen wel dat iemand een besluit neemt.
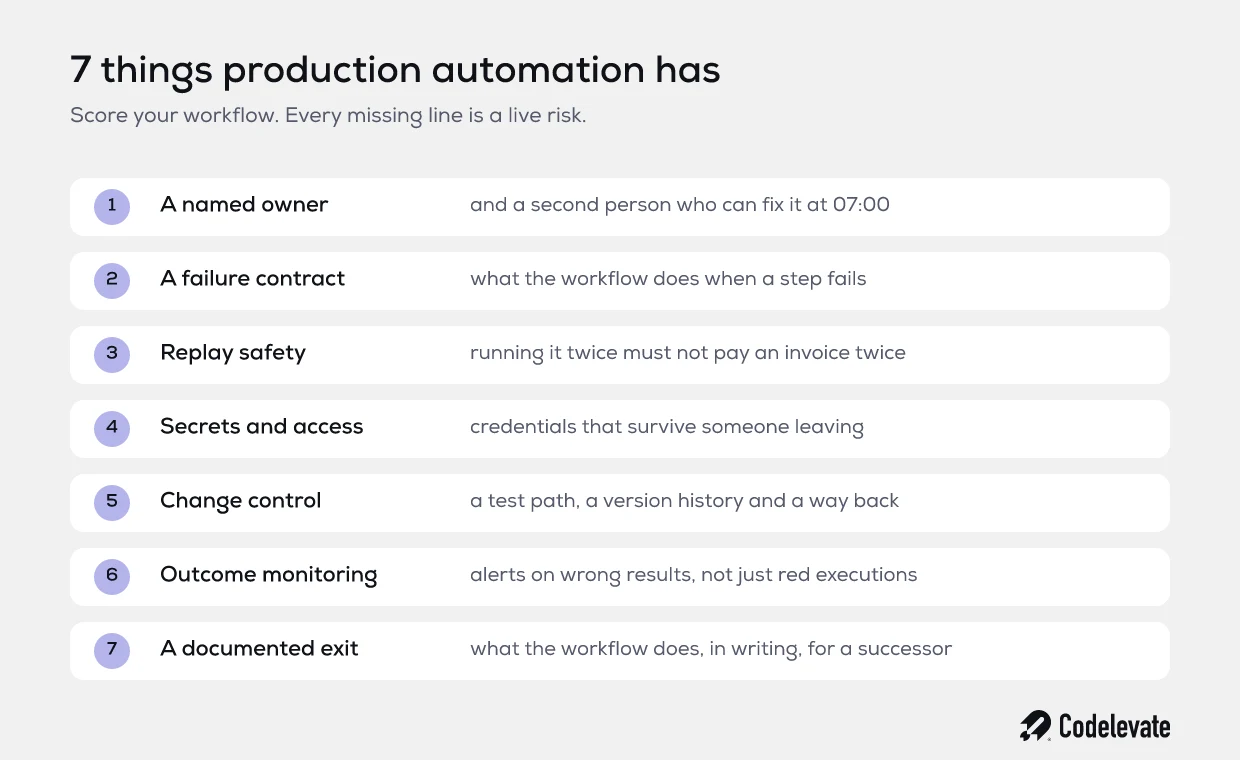
1. Een eigenaar met naam, en een tweede persoon
Zet een naam bij elke workflow die een grens over is, en zet er daarna een tweede naam bij. De eerste persoon is verantwoordelijk voor de vraag of het ding nog klopt. De tweede is degene die het om 07:00 kan repareren als de eerste in een vliegtuig zit.
De busfactor op bedrijfsautomatiseringen is standaard 1, en die ene persoon zit meestal bij operations en niet bij engineering. Daardoor valt het buiten elk proces waarmee je engineeringteam risico beheerst. Dat is geen verwijt aan de bouwer. Het is een gat in hoe het bedrijf deze categorie behandelt.
2. Een afspraak over falen
Nog voor je iets technisch aanraakt, beantwoord je 1 vraag per workflow: als een stap faalt, wat moet er dan gebeuren met het werk dat onderweg is? Er zijn maar 4 eerlijke antwoorden, en kiezen is een bedrijfsbeslissing, geen voorkeur van een ontwikkelaar.
• Alles stoppen en een mens waarschuwen, omdat een halve run erger is dan geen run.
• Dit item overslaan, loggen, met de rest doorgaan en iemand aan het eind van de dag een lijstje geven.
• Een vast aantal keer opnieuw proberen en daarna escaleren.
• Het item in een wachtrij zetten voor handmatige controle voordat het het bronsysteem raakt.
Zodra je het antwoord hebt, kan n8n het uitvoeren. Het platform ondersteunt per workflow een aparte foutworkflow die bij een mislukte uitvoering draait en de fout, de falende node en de uitvoeringsgegevens meekrijgt, en dat is precies wat je in een echte melding stopt. De n8n-documentatie over nette foutafhandeling beschrijft de techniek. Wat die documentatie niet voor je kan doen, is bepalen wat jouw bedrijf wil dat er gebeurt.
3. Herhaalveiligheid
Dit is het onderdeel dat achteraf het duurst is, dus beslis er vroeg over. Als dezelfde invoer twee keer binnenkomt, of iemand draait een mislukte uitvoering opnieuw om hem te repareren, verandert de wereld dan twee keer?
Een workflow die een mail dubbel stuurt, is gênant. Een workflow die een betaling, een inkooporder of een klantrecord dubbel aanmaakt, is een financieel probleem met een papieren spoor. De oplossing is een vaste idempotentiesleutel bij elke schrijfactie: een ordernummer, een factuurreferentie, een bericht-ID, gecontroleerd tegen het doelsysteem voordat er geschreven wordt. Dat is 15 minuten nadenken en 1 extra node. Zonder die sleutel is elke retry die je bouwt een geladen wapen gericht op je eigen grootboek.
4. Toegang die een vertrekkende collega overleeft
Open je lijst met credentials en vraag van wie die eigenlijk zijn. In de meeste landschappen die we bekijken is het antwoord een persoonlijk account: iemands Google-login, iemands API-token, iemands mailbox. Als die persoon vertrekt, of simpelweg een wachtwoord wijzigt, beginnen workflows te falen op een manier die niemand koppelt aan de offboarding van 3 weken eerder.
Serviceaccounts met de minimale rechten die de workflow echt nodig heeft zijn de oplossing. Controleer meteen waar de workflow allemaal bij kan. Een node met een volledig admintoken om 1 veld bij te werken maakt een incident veel groter dan nodig was.
5. Wijzigingsbeheer
Productiesoftware heeft een versiegeschiedenis, een manier om een wijziging te testen voordat hij live gaat, en een weg terug. De meeste bedrijfsautomatiseringen hebben iemand die de live workflow aanpast terwijl hij draait.
Je hebt geen volledige engineeringceremonie nodig. Je hebt 3 dingen nodig: een kopie van de workflow die je veilig kunt wijzigen, een klein setje bekende invoeren dat je erdoorheen haalt voordat je een wijziging doorzet, en een export van wat gisteren werkte. Die middelste weegt het zwaarst. Een workflow van 30 nodes controleer je niet door ernaar te kijken, en degene die hem het slechtst begrijpt is de persoon die hem 6 maanden geleden bouwde.
6. Uitkomsten bewaken, niet uitvoeringen
Uitvoeringsmonitoring beantwoordt of de workflow gedraaid heeft. Uitkomstmonitoring beantwoordt of hij klopte, en dat is de monitoring die stil falen vangt.
De praktische versie is goedkoper dan hij klinkt. Kies 2 of 3 getallen die het proces hoort op te leveren en meld het wanneer ze afwijken. Maak je normaal 150 tot 220 orders per dag, dan vangt een melding op elke dag onder de 100 dat hernoemde veld ruim voor een klant dat doet. Heeft normaal 6% van de items een menselijke controle nodig, dan betekent een dag op 0% dat de classificatie is gestopt, niet dat de kwaliteit omhoog ging. Volume, uitzonderingspercentage en doorlooptijd vinden het meeste van wat je uitvoeringslijst verbergt.
7. Een gedocumenteerde uitgang
Eén pagina per kritieke workflow: wat hij in bedrijfstermen doet, wat hij raakt, wat er gebeurt als hij stukgaat, wie je belt, en hoe je dit een dag met de hand doet als hij uit ligt. Bestaat die pagina niet, dan is de workflow een enkel faalpunt dat toevallig de naam van een persoon draagt.
Een uitgewerkt voorbeeld: 180 orders per dag
Een groothandel waar we mee werkten, ongeveer 40 mensen, nam klantorders per mail aan. Een operationeel manager bouwde een n8n-workflow die de mailbox las, met een model de artikelcodes en aantallen uit het bericht haalde, die tegen de catalogus matchte en de order in het ERP aanmaakte. Bouwen kostte 2 weken en het scheelde zo'n 5 uur typen per dag. Met elke redelijke maatstaf een succes.
18 maanden later verwerkte hij 180 orders per dag en waren alle 3 de grenzen gepasseerd. Hij schreef naar het ERP, de hele verkoopbinnendienst leunde erop, en een verkeerde order stuurde pallets naar het verkeerde adres. Wat het probleem aan het licht bracht was een ronde creditnota's: in 2 weken waren er 23 dubbele orderregels aangemaakt, goed voor ongeveer 4.100 euro aan retouren, administratie en 1 oprecht geïrriteerde klant. De oorzaak was een retry op een timeout, bij een workflow zonder idempotentiesleutel.
Het gevoel in de kamer zei: herbouwen als een echte dienst. In plaats daarvan hebben we hem tegen de signalen gescoord. Het volume was 180 orders per dag, dat is niets. De logica was 22 nodes en was in een jaar nauwelijks veranderd. Er was geen auditeis. Maar de kosten van een verkeerde schrijfactie waren echt geld, en 1 persoon bezat het geheel.
Dus we hebben niet herbouwd. We hebben een idempotentiecontrole op de ERP-orderreferentie toegevoegd, de ERP-schrijfactie verplaatst naar een kleine dienst met validatieregels die het ops-team niet per ongeluk kan wijzigen, de modeluitvoer bij lage zekerheid naar een controlewachtrij geleid, een foutworkflow toegevoegd die storingen in het kanaal van de verkoopbinnendienst plaatst, en een dagelijkse melding op ordervolume en uitzonderingspercentage gezet. Dat was 3 weken werk in plaats van 4 maanden. De workflow is nog steeds een n8n-workflow. Hij is alleen niet langer het enige dat tussen een timeout en een dubbele pallet staat.
Houden, splitsen of herbouwen
Als een automatisering op dit punt komt zijn er 3 eerlijke opties, en de standaardreflex om alles in code te herbouwen levert meestal de slechtste prijs-kwaliteitverhouding. Lees elk signaal apart. Landen er 2 of meer in dezelfde kolom, dan heb je je antwoord.
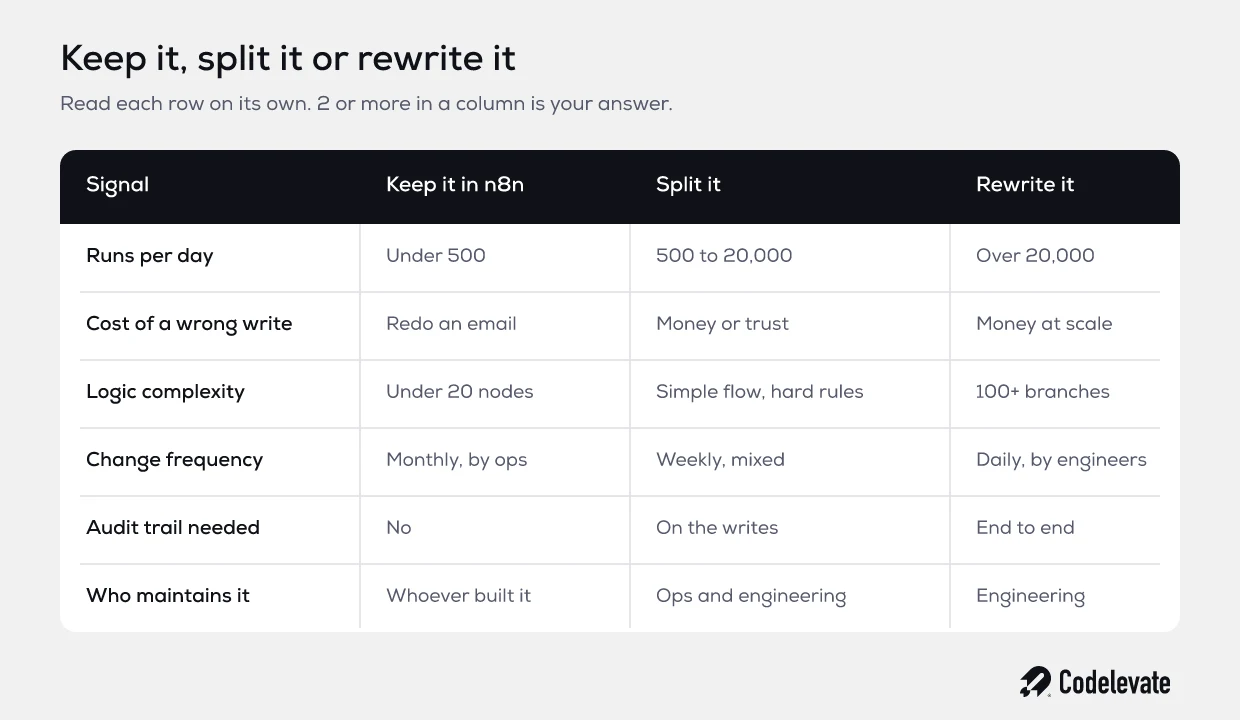
In n8n houden is veel vaker het juiste antwoord dan engineers graag toegeven. Verandert het proces maandelijks en zit degene die het wijzigt bij operations, dan verandert het verplaatsen van die logica naar code een wijziging van 1 uur in een sprintticket. Je hebt dan betrouwbaarheid gekocht met flexibiliteit, en voor de meeste interne processen is dat een slechte ruil.
Herbouwen verdient zijn prijs als meerdere signalen het eens zijn: hoog volume, complexe vertakte logica, een auditspoor dat een toezichthouder moet doorstaan, en dagelijkse wijzigingen die toch al door engineers worden gedaan. Eén signaal alleen is niet genoeg. Genoeg teams herbouwen omdat een workflow gênant werd om naar te kijken, en dat is een esthetisch argument met een prijskaartje van 4 maanden.
Het splitspatroon, dat de meeste artikelen overslaan
De middelste optie is degene die in elk vergelijkingsstuk ontbreekt, en het is de optie die wij het vaakst aanraden.
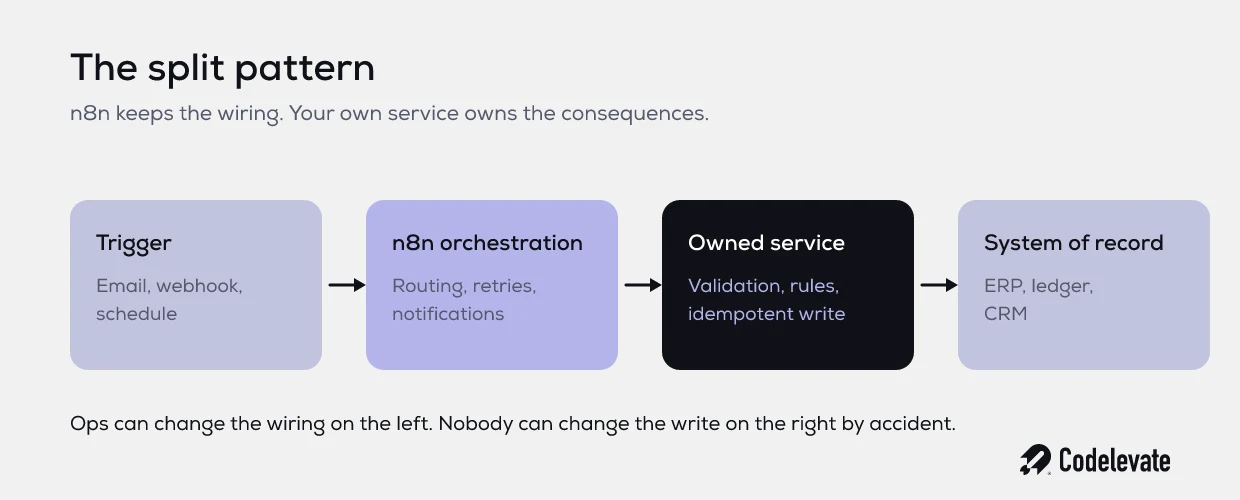
Splits de workflow op de lijn waar de gevolgen beginnen. n8n houdt waar het echt goed in is: triggers, routering, retries, meldingen, 9 systemen verbinden zonder 9 integraties te schrijven. De stap die de wereld verandert gaat achter een kleine dienst van jezelf, met validatie, een idempotentiesleutel, logging en tests.
Het ops-team houdt zijn snelheid op alles links van die lijn. Ze kunnen een melding toevoegen, een route wijzigen of een nieuw mailformaat aan, zonder een ticket in te dienen. Niemand kan per ongeluk veranderen wat het betekent om een order aan te maken, want dat staat nu in code met een test eromheen. Je hebt engineeringdiscipline gezet op de 5% van het proces waar een fout geld kost, en de andere 95% flexibel gelaten.
In de praktijk is dit vaak 1 endpoint en een paar honderd regels. Het is de goedkoopste risicoverlaging die er in een automatiseringslandschap te halen valt, en je hebt er geen architectuurprogramma voor nodig.
Het infrastructuurdeel, kort
Host je zelf en loopt het volume op, dan zit er een echt technisch plafond op één n8n-instantie, en het antwoord is queue mode: een hoofdinstantie die triggers en webhooks afhandelt, Redis als broker, en workers die de workflows uitvoeren. De eigen handleiding van n8n over queue mode inschakelen zet de randvoorwaarden op een rij, waaronder dat queue mode PostgreSQL vraagt in plaats van SQLite, dat workers standaard 10 gelijktijdige taken draaien, en dat elke worker dezelfde encryptiesleutel als de hoofdinstantie moet hebben.
Ga naar Postgres voordat je het nodig hebt, niet tijdens een storing. Behandel dit verder als de makkelijke helft van het probleem. Infrastructuur heeft documentatie, verstandige standaardwaarden en een leverancier die belang heeft bij jouw succes. Eigenaarschap, afspraken over falen en herhaalveiligheid hebben dat allemaal niet, en dat zijn de dingen waar bedrijven echt op onderuitgaan.
Hoe wij dit bij Codelevate aanpakken
Als een klant ons vraagt naar een automatiseringslandschap te kijken, beginnen we niet bij de tooling. We brengen in kaart welke workflows de 3 grenzen over zijn, scoren elke workflow tegen de 7 eigenschappen en maken een korte lijst, gerangschikt op wat een storing echt zou kosten. Het is heel normaal om 30 of 40 workflows te vinden waarvan er 3 vrijwel al het risico dragen.
Daarna repareren we die 3, meestal met het splitspatroon, en laten we de rest met rust. Als AI-automatiseringsbureau zouden we meer verdienen aan een voorstel voor een complete herbouw. Dat is zelden het juiste advies, en het is een trage manier om risico te verlagen dat je ook in 2 weken had kunnen verlagen. Wil je het aangrenzende vraagstuk van wie er na de livegang voor een geautomatiseerd systeem zorgt, daar gingen we dieper op in bij wie er na de lancering eigenaar is van je AI-agent.
Waar dit je brengt
De verandering hier is klein en weinig spectaculair. Je gaat van een automatiseringslandschap dat werkt tot het stilletjes niet meer werkt, naar een landschap waarin je weet welke workflows ertoe doen, wie ze bezit, wat ze doen als ze stukgaan en wat het kost als ze 2 weken fout zitten. Dat is het verschil tussen automatisering als productiviteitstruc en automatisering als infrastructuur waar je een bedrijf op bouwt.
Begin met de oefening van 20 minuten. Zet je workflows op een rij, markeer de 3 grenzen en kies de workflow met de duurste storing. Geef die deze maand een eigenaar, een afspraak over falen en een idempotentiesleutel. Die 3 alleen al halen het meeste risico uit de meeste landschappen.
Wil je het bredere kader om te bepalen waar automatisering en AI een echte investering waard zijn, dan is de SaaS AI Blueprint gratis en gaat hij verder dan dit artikel kan.
En weet je al welke workflow je 's nachts wakker houdt, plan dan een gratis gesprek met ons team. We kijken naar wat je draait en zeggen eerlijk of het 3 weken verstevigen nodig heeft of een herbouw.