AI-teamstructuur in 2026: de 7 taken die je afdekt voordat je gaat werven
Een oprichter vertelde ons vorige maand dat de raad van bestuur budget had goedgekeurd voor een AI-team. Vier mensen: een machine learning engineer, een data scientist, een MLOps engineer en een data engineer. De vraag was hoe lang het zou duren om ze te werven. Het eerlijke antwoord was dat het bedrijf nog geen van hen nodig had, en dat het overgenomen organogram gebouwd was voor werk dat dit bedrijf nooit zou gaan doen.
Dit is op dit moment de duurste fout in AI-werving. Bijna elke gids over AI-teamstructuur is geschreven door een recruitmentbureau, en beschrijft het team dat je bouwt om modellen te trainen. De meeste bedrijven trainen geen modellen. Ze roepen via een API het model van een ander aan en proberen het systeem eromheen betrouwbaar genoeg te maken om aan klanten te laten zien. Dat zijn verschillende problemen, en ze vragen om verschillende mensen.
Dit artikel geeft je dus geen organogram. Het geeft je de 7 taken die bepalen of een AI-functie live gaat of stilletjes sterft, laat zien welke daarvan je huidige team al afdekt, en benoemt de 2 die standaard door niemand worden opgepakt. Daarna vertalen we die taken naar 3 concrete teamvormen per fase, krijg je 4 toetsen om te bepalen of je echt een machine learning-specialist nodig hebt, en bespreken we eerlijk de keuze tussen zelf bouwen en een partner.
Het is geschreven voor oprichters, CTO's en productleiders bij SaaS-bedrijven en mkb-bedrijven die foundation models inbouwen in een product dat ze al draaien. Train je je eigen modellen, bouw je een onderzoeksgroep op, of is het model zelf je intellectueel eigendom, dan is het klassieke machine learning-organogram de juiste keuze en is dit stuk niet voor jou.
Belangrijkste inzichten
• AI-teamstructuur draait in 2026 om taken die eigenaarschap nodig hebben, niet om functietitels die je moet werven.
• 7 taken bepalen of een AI-functie productie haalt. Een normaal productteam dekt er al 4 af.
• De 2 echt nieuwe taken zijn evaluatie en eigenaarschap na de lancering. Beide zijn meestal niet toegewezen, en daar lopen projecten vast.
• Je eerste AI-functie zou 0 nieuwe medewerkers moeten vragen. Lukt dat niet, dan heb je waarschijnlijk het verkeerde eerste probleem gekozen.
• De juiste eerste AI-hire is een backend engineer met productgevoel, geen onderzoeker.
• Je hebt een machine learning-specialist alleen nodig als 1 van 4 specifieke voorwaarden geldt. Voor de meeste SaaS-bedrijven geldt er geen enkele.
• Gartner verwacht dat meer dan 40% van de agentic AI-projecten eind 2027 is stopgezet, en de redenen die het noemt zijn problemen met bemensing en eigenaarschap, geen modelproblemen.
Wat betekent AI-teamstructuur in 2026?
AI-teamstructuur is de verdeling van verantwoordelijkheden waarmee een bedrijf een AI-functie kan kiezen, bouwen, meten en werkend houden in productie. In 2026 is het vooral een vraag over eigenaarschap en minder een vraag over aantallen mensen, omdat de modellaag waarvoor je vroeger een onderzoeksteam nodig had nu een API van een leverancier is.
Die verschuiving is groter dan ze klinkt. Vijf jaar geleden betekende een AI-functie bouwen: trainingsdata verzamelen, een architectuur kiezen, trainen, tunen en een model serveren. Elke stap vroeg om een specialist, dus het organogram zat vol specialisten. Vandaag roept een goede backend engineer een frontier-model aan en krijgt een antwoord waar een onderzoeksteam in 2020 18 maanden over zou hebben gedaan.
Wat niet makkelijker is geworden, is alles rondom het model. De juiste context voor het model krijgen. Weten of het antwoord klopte. Bepalen wat er gebeurt als het fout is. Voorkomen dat de kosten per request ongemerkt verdrievoudigen. Weten wie over zes maanden verantwoordelijk is als de kwaliteit wegzakt en niemand het merkt. Dat werk is gegroeid, en het is geen machine learning-werk. Het is product- en engineeringwerk met een nieuwe manier van falen.
McKinsey's State of AI-onderzoek Laten we kijken waar het verschil echt vandaan komt. Bijna driekwart van de bedrijven die als koploper worden gezien, geeft aan werkprocessen fundamenteel te hebben herontworpen vanwege AI, tegenover ongeveer een kwart van de rest. Het verschil tussen bedrijven die waarde halen en bedrijven die dat niet doen, zit niet in de kwaliteit van het model. Iedereen gebruikt dezelfde modellen. Het verschil zit in hoe het werk rondom het model is georganiseerd.
Waarom het standaard AI-organogram het verkeerde sjabloon is
Zoek op AI-teamstructuur en je vindt op elke pagina dezelfde lijst: AI-productmanager, machine learning engineer, data scientist, data engineer, MLOps engineer en steeds vaker een AI governance lead. Ze beschrijven een specifiek type team. Het probleem is wie ze publiceert.
Bijna al deze artikelen komen van recruitmentbureaus en outsourcingbedrijven. Hun verdienmodel is mensen plaatsen, dus het antwoord op elke vraag is een persoon. Een gids met de conclusie "je hebt waarschijnlijk 0 nieuwe mensen nodig en moet 2 bestaande collega's andere taken geven" zou commercieel nutteloos zijn voor de schrijver.
De schade laat zich op drie manieren zien. Ten eerste de kosten: een specialistenteam van vier mensen in West-Europa kost al snel 400.000 euro per jaar inclusief werkgeverslasten, uitgegeven voordat je weet of de functie werkt. Ten tweede de snelheid: die rollen vullen duurt in een krappe markt maanden, dus het project staat stil in de wervingsfase in plaats van de bouwfase. Ten derde, en het ergst, de fit. Een sterke machine learning engineer die prompts moet schrijven en API-aanroepen moet koppelen, verveelt zich binnen een kwartaal en is binnen drie kwartalen weg.
Er is een helderdere manier om ernaar te kijken. Gartner voorspelt dat meer dan 40% van de agentic AI-projecten eind 2027 is stopgezet, en noemt als oorzaken oplopende kosten, onduidelijke bedrijfswaarde en onvoldoende risicobeheersing. Geen van die oorzaken is een modelprobleem. Het zijn allemaal gevolgen van onduidelijkheid over wie waarvoor verantwoordelijk was.
De 7 taken achter elke AI-functie die live gaat
Dit is het raamwerk dat we gebruiken wanneer een klant ons vraagt een AI-initiatief te bemensen. Vraag niet welke rollen je moet werven, maar maak een lijst van de taken die een eigenaar nodig hebben, en vraag dan wie in het huidige team elke taak kan oppakken. Taken zijn geen mensen. Eén persoon kan er drie dragen, en in een vroege fase is dat meestal zo.
1. Probleemkeuze
Iemand moet bepalen welk werkproces een AI-functie krijgt, en, lastiger, welke niet. Dit is de taak met de meeste impact op de lijst en de taak die het vaakst wordt overgeslagen, omdat het voelt alsof hij al gedaan is zodra iemand zegt: "laten we AI gebruiken voor supporttickets."
Goede probleemkeuze betekent een werkproces kiezen waarin de input rommelig genoeg is dat gewone code faalt, het volume hoog genoeg is om ertoe te doen, een incidentele fout overleefbaar is en een goed antwoord herkenbaar is. Sla een van die vier over en geen hoeveelheid engineering redt het project. Deze taak hoort bij een productleider of de oprichter, en is zelden een fulltime rol.
2. Context en datakoppelingen
Het model weet alleen wat je het voorlegt. Iemand moet de juiste records, documenten en historie in elk request krijgen, met respect voor rechten, zonder dat de wachttijd of de tokenkosten de pan uit rijzen.
Teams onderschatten dit consequent. Het is het grootste blok engineeringwerk in een gemiddelde AI-functie, en het is gewoon backend-werk: systemen bevragen, data vormgeven, cachen, verouderde records afhandelen en afdwingen wie wat mag zien. Je huidige backend engineer kan dit. Na een paar weken heeft die gevoel voor retrieval, en de vaardigheden zijn direct overdraagbaar.
3. Evaluatie
Iemand moet vastleggen hoe een goed antwoord eruitziet en dat continu meten. Dit is de eerste echt nieuwe taak op de lijst, en in de meeste teams is niemand er eigenaar van.
Gewone software heeft tests die slagen of falen. Een AI-functie heeft uitkomsten die beter of slechter zijn, en de enige manier om te weten welke het is, is een set echte cases met bekende goede antwoorden opbouwen en daartegen scoren bij elke wijziging aan een prompt, een model of een retrieval-stap. Zonder dat vlieg je blind. Je kunt niet zien of een wijziging hielp, je kunt een modelupgrade niet veilig accepteren en je kunt een klant die zegt dat de kwaliteit daalde geen antwoord geven. Teams die evaluatie overslaan, merken dat niet meteen. Ze merken het vier maanden later, als het vertrouwen weg is.
4. Ontwerp voor fouten
Iemand moet bepalen wat er gebeurt als het model fout zit, want dat gaat gebeuren. Gaat het antwoord direct naar een klant of eerst langs een beoordelaar? Kan de gebruiker zien waarop het systeem zijn conclusie baseerde? Kan een actie worden teruggedraaid? Hoe groot is de schade van één slechte uitkomst?
Dit is product- en ontwerpwerk, geen engineeringwerk, en hier wordt het verschil bepaald tussen een functie die mensen vertrouwen en een functie die mensen stilletjes niet meer gebruiken. Je huidige productleider en ontwerper kunnen dit oppakken. Wat ze nodig hebben, is de expliciete opdracht dat het ontwerpen van het foutpad onderdeel is van de functie, en geen randgeval voor later.
5. Kosten en snelheid
Iemand moet eigenaar zijn van wat een request kost en hoe lang het duurt. In gewone software zijn dat optimalisatievragen waar je af en toe naar kijkt. Bij AI-functies zijn het vanaf dag één productbeperkingen, omdat de kosten meeschalen met gebruik op een manier die hosting nooit deed, en omdat een antwoord van 9 seconden verandert wat de functie mag zijn.
Het werk is concreet: kosten per request per functie meten, stevig cachen, eenvoudige requests naar kleinere modellen sturen en moeilijke naar grotere, en context weghalen die zijn plek niet verdient. Een platform- of senior backend engineer pakt dit snel op. Het is een nieuwe discipline, geen nieuwe persoon.
6. Vertrouwen en compliance
Iemand moet op papier kunnen uitleggen welke data je systemen verlaat, waar die wordt verwerkt, hoe lang iemand die bewaart en wat je het securityteam van een zakelijke klant vertelt. In Europa is dit niet optioneel, en de vraag komt eerder dan mensen verwachten, meestal midden in een deal.
Dit is doorgaans een parttime taak voor de CTO, met juridische ondersteuning. Een aparte governance-hire is pas nodig als je flink groter bent dan de meeste bedrijven die dit lezen.
7. Eigenaarschap na de lancering
Iemand moet eigenaar zijn van de functie zodra die live staat. Wie wordt gebeld als de kwaliteit wegzakt? Wie bekijkt elke maand de evaluatiescores? Wie besluit of je de volgende modelversie van de leverancier overneemt, en wie test die voordat hij erin gaat?
Dit is de tweede echt nieuwe taak, en degene die we het vaakst zonder eigenaar zien. AI-functies falen niet luid zoals een storing. Ze gaan langzaam achteruit. De leverancier stopt met een model, je stapt over op de opvolger, de API geeft nog steeds een 200 terug, en het gedrag verschuift op manieren die wekenlang niemand opmerkt. Staat er geen naam bij deze taak, dan is niemand eigenaar, en dat ontdek je tijdens een incident.
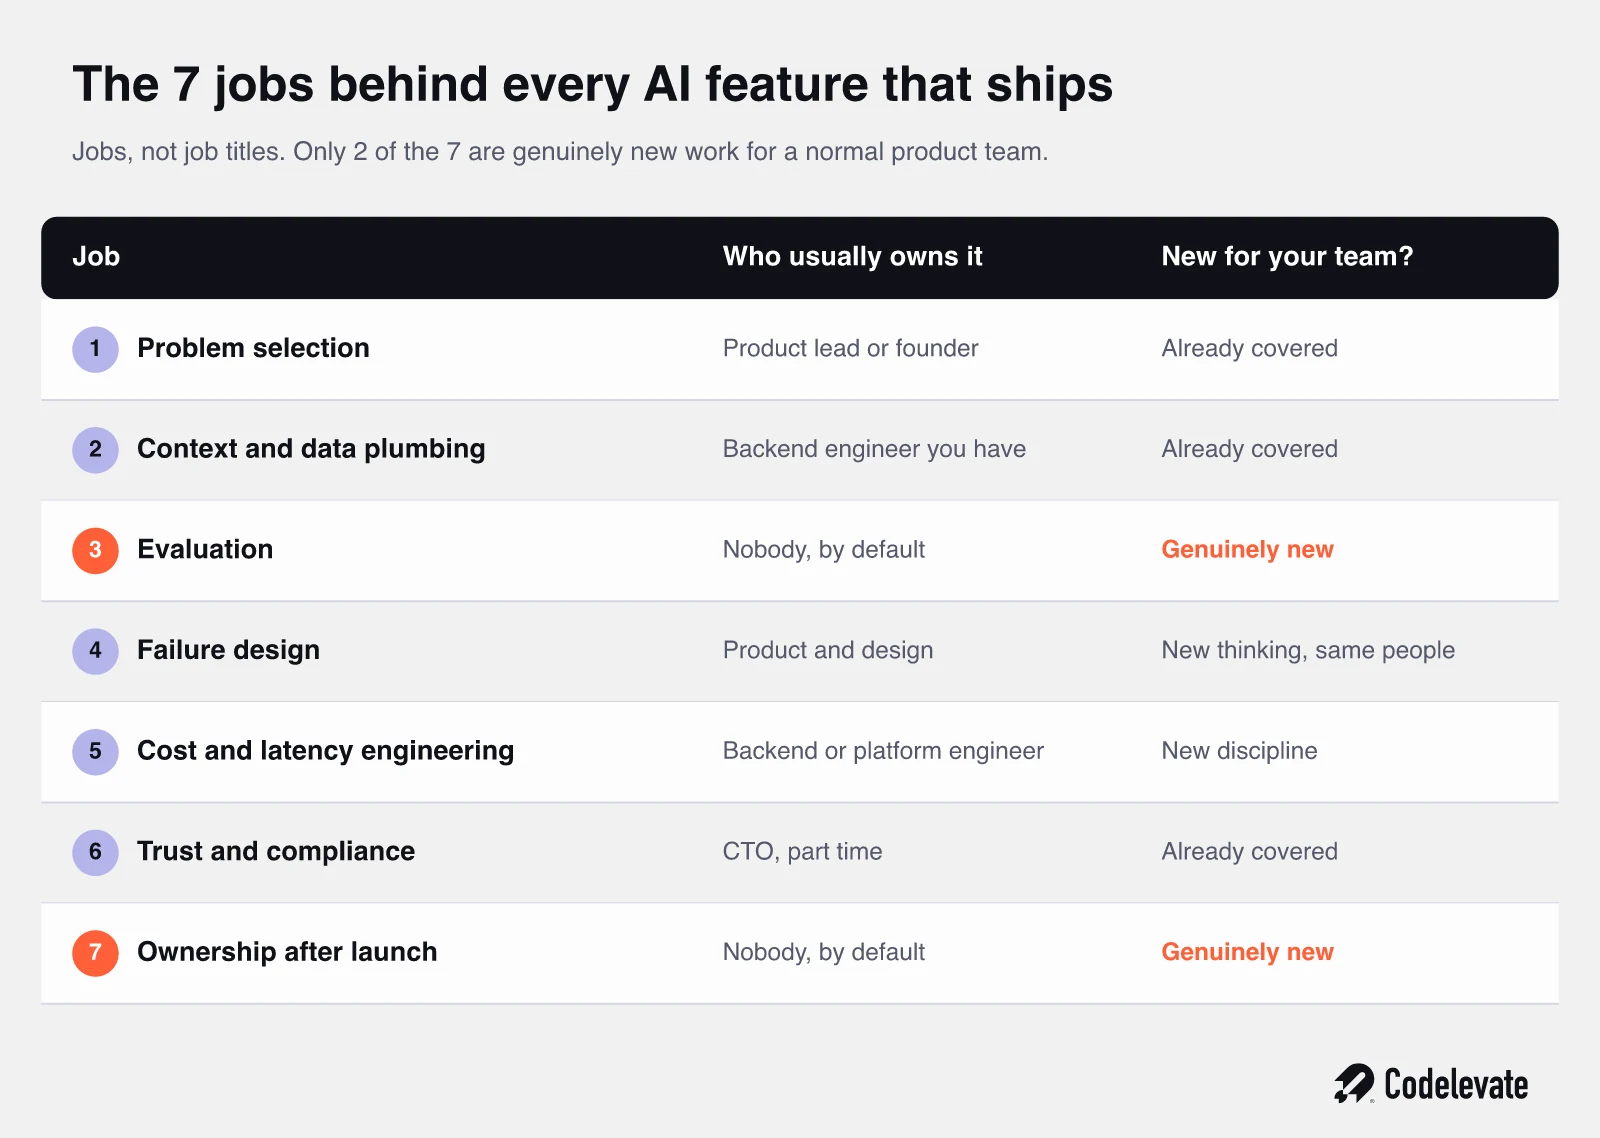
De 2 taken die niemand toewijst
Kijk nog eens naar het overzicht en let op het patroon. Taken 1, 2, 4 en 6 passen netjes bij mensen die je al in dienst hebt. Taak 5 is nieuw werk voor een bestaande engineer. Alleen taken 3 en 7, evaluatie en eigenaarschap na de lancering, hebben geen natuurlijke plek in een normaal productteam.
Dat is geen toeval, en het verklaart de meeste AI-projecten waarvoor we worden gebeld om ze te redden. Een team bouwt in drie weken een demo, iedereen is onder de indruk, en hij gaat naar productie. Niemand bouwde een evaluatieset, dus er is geen nulmeting. Niemand werd als eigenaar benoemd, dus als een klant meldt dat de antwoorden slechter zijn geworden, zoeken drie mensen een dag lang en concluderen dat het waarschijnlijk wel meevalt. Zes maanden later wordt de functie uitgezet, en in de evaluatie staat dat de technologie er nog niet klaar voor was.
De technologie was prima. Twee taken hadden geen eigenaar.
De oplossing kost aan het begin bijna niets en is duur om achteraf in te bouwen. Verzamel voordat je de eerste prompt schrijft 50 echte cases met bekende goede antwoorden. Zet een naam bij de evaluatieset en een naam bij de live functie, en geef beide mensen elke maand een vast uur. Dat is de hele ingreep.
Wil je hier dieper op ingaan, dan beschrijft onze AI-blauwdruk voor SaaS-oprichters hoe je een AI-functie afbakent, bemenst en plant zodat hij het contact met echte gebruikers overleeft. Hij is gratis.
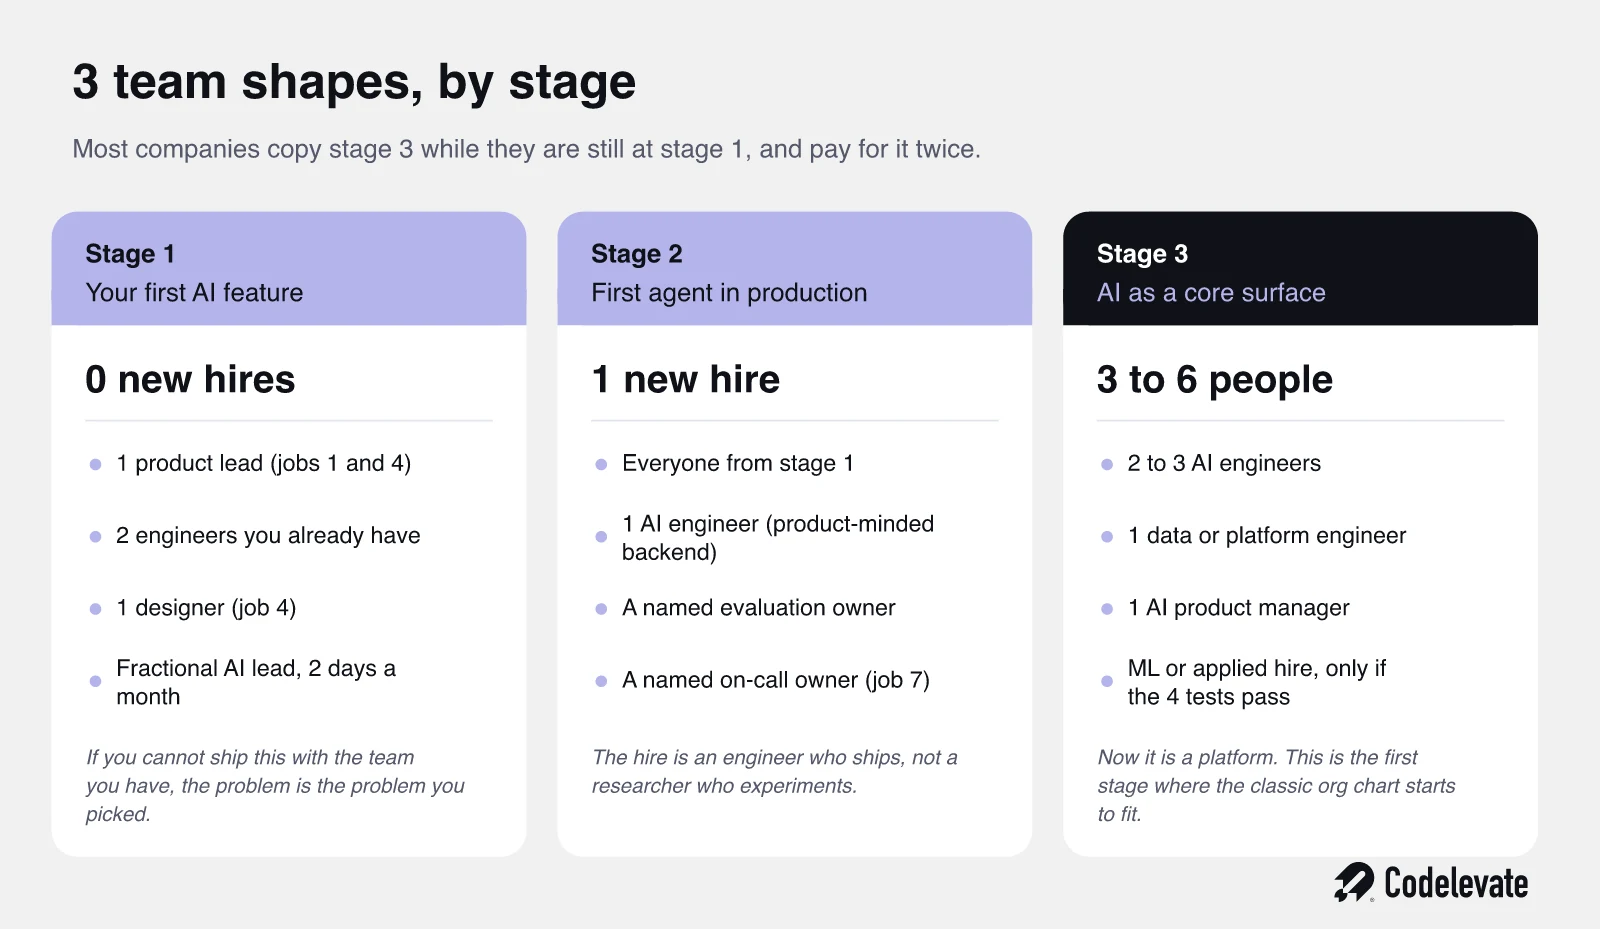
3 teamvormen per fase
Zodra de taken helder zijn, volgt de teamvorm vanzelf. De fout die we het vaakst zien, is een bedrijf dat de structuur kopieert van een bedrijf dat twee fases verder is, en een jaar voor die structuur betaalt voordat de eerste functie live gaat.
Fase 1: je eerste AI-functie
0 nieuwe medewerkers. Een productleider die eigenaar is van probleemkeuze en het ontwerp voor fouten, twee engineers die je al hebt, een ontwerper, en bij voorkeur een ervaren AI-lead voor een paar dagen per maand om de dure fouten vroeg te voorkomen. Veel bedrijven regelen dat laatste met een fractional CTO in plaats van een vaste aanstelling.
De reden om hier bij 0 nieuwe mensen te blijven, is diagnostisch. Kan je eerste AI-functie echt niet gebouwd worden door je huidige team met af en toe senior begeleiding, dan is dat een sterk signaal dat je een eerste probleem koos dat te moeilijk, te breed of te centraal is. Kies een smaller probleem. De eerste functie is er om je team te leren hoe deze technologie zich in jouw product gedraagt, niet om het bedrijf te transformeren.
Fase 2: je eerste agent in productie
1 nieuwe medewerker. Als de functie werkt en je overstapt van een enkele aanroep naar iets dat meerdere stappen zet en in echte systemen handelt, wordt de belasting op taken 2, 3 en 5 groter dan een parttime eigenaar kan dragen.
De nieuwe collega is een AI engineer, en het profiel is belangrijker dan de titel. Je zoekt een sterke backend engineer met productgevoel die al LLM-functies aan echte gebruikers heeft opgeleverd. Je zoekt geen onderzoeker. Het dagelijkse werk bestaat uit integratie, retrieval, evaluatie, kostenbeheersing en vreemd gedrag debuggen, en wie eerder beroepsmatig modellen trainde, vindt dat onbevredigend. Dit is ook de fase waarin evaluatie en eigenaarschap na de lancering een expliciete naam moeten krijgen, geen impliciete.
Fase 3: AI als kern van het product
3 tot 6 mensen. AI is nu de kern van het product in plaats van een functie erin: 2 tot 3 AI engineers, een data- of platform engineer die eigenaar is van pipelines en infrastructuur, en een AI-productmanager. Dit is de eerste fase waarin het standaardorganogram van een recruitmentblog je werkelijke situatie begint te beschrijven, en ook de eerste fase waarin een machine learning-hire te verdedigen is, als de toetsen hieronder dat bevestigen.
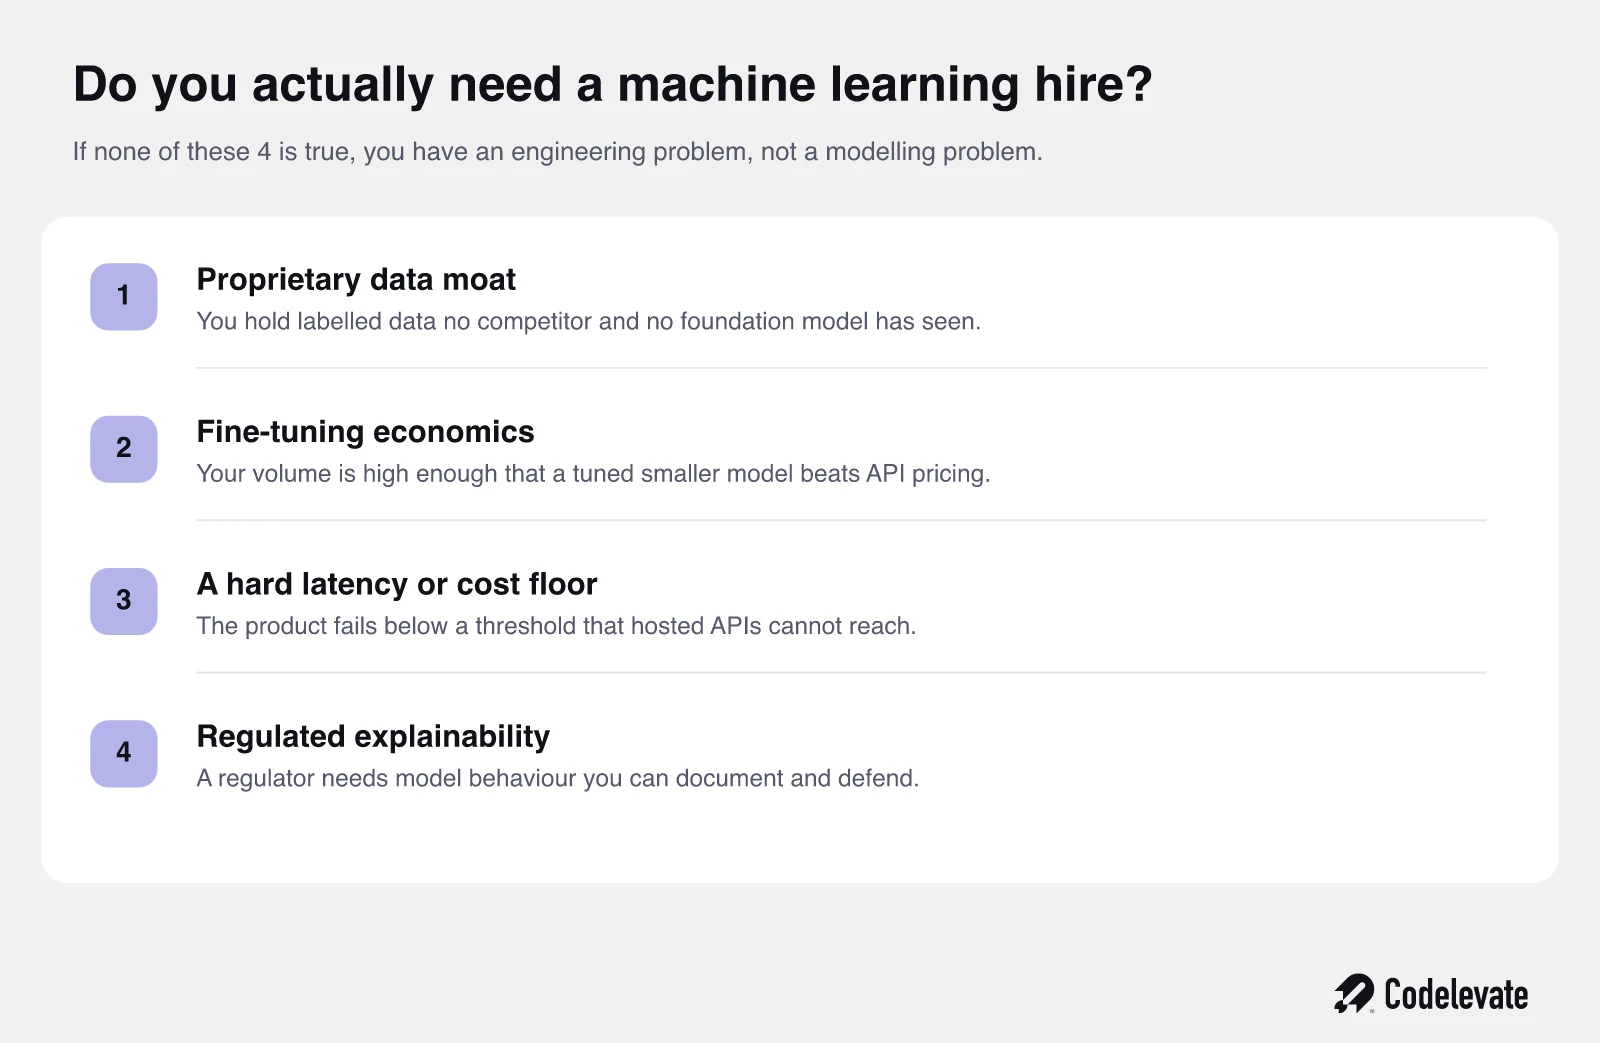
Wanneer heb je echt een machine learning-specialist nodig?
Je hebt een machine learning-specialist nodig als minstens 1 van deze 4 voorwaarden geldt. Geldt er geen, dan is zo'n aanstelling duur, en ben je die persoon waarschijnlijk binnen een jaar kwijt aan een bedrijf dat wel het werk biedt waarvoor die is opgeleid.
• Je hebt eigen gelabelde data die geen concurrent en geen foundation model heeft gezien, en die data is het echte concurrentievoordeel.
• Je volume is zo hoog dat fine-tuning van een kleiner model goedkoper is dan API-prijzen, met genoeg marge om de engineering te rechtvaardigen. In de praktijk gaat het dan om miljoenen requests, niet om duizenden.
• Het product heeft een harde grens voor snelheid of kosten die gehoste modellen niet halen, waardoor je iets kleiners zelf moet hosten.
• Je werkt in een gereguleerde omgeving waar een toezichthouder modelgedrag eist dat je kunt documenteren, reproduceren en verdedigen, en een API van een leverancier kan dat niet bieden.
De meeste SaaS-bedrijven voldoen aan geen van deze voorwaarden. Dat is een goede positie, geen beperking. Het betekent dat je voordeel zit in het werkproces, de toegang tot data en de kwaliteit van het systeem eromheen. Dat kunnen je huidige engineers allemaal bouwen, zonder dat je hoeft te concurreren om schaars onderzoekstalent.
De eerlijke versie van dit advies drukken de meeste wervingsgidsen niet af: voor de meeste bedrijven die in 2026 AI in een bestaand product bouwen, is de modellaag een inkoopbeslissing, en zit het onderscheid in engineeringdiscipline.
5 wervingsfouten rond AI die we het vaakst zien
Ze komen van bedrijven die het eerst zelf probeerden, en ze herhalen zich opvallend vaak.
• Als eerste een machine learning-onderzoeker aannemen. Het werk blijkt integratie-engineering te zijn, de nieuwe collega wordt onderbenut en beide kanten zijn teleurgesteld.
• Een promptspecialist aannemen als losse rol. Prompten is nu een vaardigheid binnen engineering- en productrollen, zoals SQL. Het is geen functieomschrijving, en een rol eromheen bouwen levert iemand op zonder duidelijk loopbaanpad en zonder eigenaarschap over resultaten.
• AI een apart team maken. Een AI-groep buiten de productorganisatie bouwt dingen die nooit worden geïntegreerd, omdat de eigenaren van het werkproces en de eigenaren van het model in verschillende overleggen zitten. AI-functies horen bij de productteams die eigenaar zijn van de werkprocessen die ze raken.
• Evaluatie niet toewijzen. Onzichtbaar tot het duur wordt.
• Probleemkeuze uitbesteden. Een partner laten bouwen is prima. Een partner laten bepalen welke problemen het oplossen waard zijn niet, omdat die niet weet welke werkprocessen echt pijn doen, en een prikkel heeft richting de ambitieuze bouw in plaats van de nuttige. Houd taak 1 altijd in huis.
Zelf bouwen, een partner of een hybride aanpak?
Alle drie werken. De keuze hangt af van hoe snel je moet bewegen en of AI een blijvende capaciteit wordt of een reeks functies die je één keer bouwt en onderhoudt.
Volledig zelf bouwen is logisch als AI de kern van je product is en je de tijd en het salarisbudget hebt om vooruit te werven. Het is de langzaamste weg naar een eerste resultaat en de sterkste positie na 18 maanden.
Met een partner werken is logisch als je de eerste functie dit kwartaal in productie wilt hebben in plaats van volgend jaar, en als je liever eerst leert wat het werk inhoudt voordat je vaste mensen aanneemt. Het risico is afhankelijkheid, en dat beheers je via het contract: zorg dat evaluatiesets, prompts en documentatie van jou zijn, en dat minstens één eigen engineer meebouwt in plaats van het eindresultaat alleen te ontvangen.
De hybride variant raden we het vaakst aan. Een partner pakt taken 2, 3 en 5 op voor de eerste twee functies, terwijl een van je eigen engineers meewerkt en het daarna overneemt. Probleemkeuze en het ontwerp voor fouten houd je vanaf dag één in huis, omdat die kennis van je bedrijf vragen. Na twee functies heeft je engineer het gevoel dat anders een jaar vallen en opstaan had gekost, en weet je op basis van bewijs of een vaste AI-hire gerechtvaardigd is.
Hoe Codelevate dit aanpakt
Als een klant ons vraagt een AI-capaciteit op te bouwen, gaat de eerste sessie niet over architectuur. We leggen de 7 taken naast de mensen die er al zijn, en meestal blijken er vier of vijf al afgedekt door iemand die nog niet weet dat het nu bij zijn of haar rol hoort. De gaten zitten bijna altijd in evaluatie en eigenaarschap na de lancering, soms in kostenbeheersing.
Van daaruit is het advies specifiek in plaats van algemeen: welke ene aanstelling je echt verder helpt, welke taken je deze week formeel aan bestaande mensen toewijst, en welke onderdelen een extern team het beste kan dragen terwijl je engineers het patroon leren. Soms is het antwoord dat je twee kwartalen een uitgebreid engineeringteam nodig hebt. Soms is het dat je niemand nieuw nodig hebt en een ander eerste probleem. We vertellen een klant liever het tweede en hebben gelijk, dan dat we het eerste verkopen.
Waar je deze week begint
AI-teamstructuur is in 2026 geen organogramprobleem. Het is een eigenaarschapsprobleem in de vermomming van een organogram. De bedrijven die waarde halen, zijn niet de bedrijven met de indrukwekkendste AI-titels, maar de bedrijven waar bij alle 7 taken een naam staat en evaluatie geen bijzaak is.
Doe dus drie dingen voordat je ook maar één vacature opent. Zet de 7 taken op een pagina en schrijf bij elke taak een naam. Omcirkel de taken zonder naam, en dat zijn vrijwel zeker evaluatie en eigenaarschap na de lancering. Kies daarna een eerste probleem dat klein genoeg is voor je huidige team, en gebruik het om te ontdekken wat je echt nodig hebt in plaats van wat een recruitmentblog je vertelde.
Wil je die oefening gestructureerd doen, dan behandelt onze AI-blauwdruk voor SaaS-oprichters afbakening, bemensing en planning in meer detail, en hij is gratis.
En wil je het liever doorlopen met iemand die dit bij tientallen projecten heeft gedaan, plan dan een gratis gesprek met ons team. We leggen de 7 taken naast je team en vertellen eerlijk waar het gat zit, ook als het antwoord is dat je niemand hoeft aan te nemen.