Multi-tenant AI in SaaS: de 4 lekpaden die row-level security mist
AI toevoegen aan een multi-tenant SaaS-product is geen featureprobleem. Het is een tenancy-probleem, en de meeste teams ontdekken dat op de slechtst denkbare plek: een security-onderzoek van een enterprise-klant, zes weken nadat de feature al live ging.
Je tenant-grens is gebouwd voor queries. Een tenant_id-kolom, row-level security, misschien een schema per klant. Die is goed getest, houdt al jaren stand, en dekt vrijwel niets van wat er met die rijen gebeurt nadat ze de database verlaten. Zodra je code een prompt samenstelt, gaat klantdata naar een systeem dat het begrip tenant helemaal niet kent.
Dit is geschreven voor founders, CTO's en engineering leads bij B2B SaaS-bedrijven die al betalende klanten hebben en beginnen te verkopen aan grotere organisaties. Bouw je een intern tool of een AI-wrapper voor één klant, dan geldt dit niet. Houdt je product data van 50 of 5.000 aparte organisaties en ga je er een model voor zetten, dan besparen de komende 10 minuten je een kwartaal engineeringtijd.
Dit krijg je: een heldere definitie van multi-tenant AI, de 4 paden waarlangs tenantdata ontsnapt zodra er een LLM in het spel is, de isolatiepatronen waaruit je kiest, de 6 maatregelen die een enterprise security-vragenlijst doorstaan, een eerlijk beeld van de kosten, en een uitgewerkt voorbeeld met echte cijfers.
Belangrijkste punten
• Multi-tenant AI is het leveren van LLM-functies aan veel klantorganisaties vanaf gedeelde infrastructuur, terwijl data, context en output van elke tenant strikt gescheiden blijven.
• Row-level security beschermt de query. Niet de prompt, de retrieval-context, de tool call of de trace, en dat zijn juist de 4 plekken waar tenantdata weglekt.
• Isolatie die alleen in applicatiecode leeft, is geen isolatie. Eén ontbrekend filter in één codepad is een lek, en LLM-codepaden vermenigvuldigen zich snel.
• Kies je isolatiepatroon bewust: silo (een index of namespace per tenant) levert een schoon auditverhaal, pool (gedeelde index met filters) levert kostenefficientïe, en een hybride past bij de meeste producten.
• Observability is het stilste lek. Traces, prompt-caches en eval-datasets kopiëren ruwe tenantcontent naar tools die geen tenantmodel kennen.
• Sensitive information disclosure staat inmiddels op plek 2 in de OWASP Top 10 voor LLM-applicaties, dus het securityteam van je koper vraagt er al naar.
• De deadline die telt is niet je releasedatum, maar de eerste enterprise security-vragenlijst met een AI-sectie erin. Security review is de grootste vertragingsbron tussen het moment dat een koper voor je kiest en het moment dat er getekend wordt.
Wat is multi-tenant AI?
Multi-tenant AI is het leveren van AI-functies aan veel aparte klantorganisaties vanaf gedeelde infrastructuur, met de garantie dat de data, opgehaalde context, modeloutput of gebruiksregistratie van geen enkele tenant bij een andere tenant terechtkomt. Het is dezelfde belofte die je database al doet, uitgesmeerd over een veel groter oppervlak.
Het woord gedeeld doet hier het werk. Bijna niemand draait een eigen model, vectordatabase en inference-endpoint per klant, want bij 300 tenants zijn die kosten absurd. Dus deel je een embedding-pipeline, een vectorstore, een prompt-template, een model-endpoint, een cache en een observability-stack. Elk daarvan is een plek waar content van tenant A en tenant B in hetzelfde proces, dezelfde index of dezelfde logregel zit, alleen gescheiden door logica die iemand geschreven heeft.
Dat verschilt wezenlijk van de multi-tenancy die je al draait. Bij een klassieke SaaS-request stroomt data uit de database naar een response en terug naar één ingelogde gebruiker. Het pad is kort en één bewaker bij de database dekt het af. Bij een AI-request gaat data naar een retrieval-stap, een prompt, een extern model, een response, een trace, een cache, en soms een evaluatiedataset die drie weken later op de laptop van een engineer opengaat. Dat pad is lang, vertakt en grotendeels onzichtbaar voor de controles die je al vertrouwt.
Waarom row-level security stopt bij de prompt
Row-level security beantwoordt één vraag: welke rijen mag deze sessie lezen. Hij beantwoordt die deterministisch, en daarom is hij al tien jaar de ruggengraat van SaaS-tenancy. Hij stopt met werken op het moment dat dat antwoord wordt doorgegeven aan iets anders.
Kijk naar wat een typische AI-functie doet. Een gebruiker inloggen, de tenant bepalen, rijen ophalen onder een tenantfilter, die serialiseren, samenvoegen met een system prompt, het geheel naar een model sturen, vrije tekst terugkrijgen en die tonen. Row-level security regelt stap 4 van 8. Stap 5 tot en met 8 gebeuren in applicatiecode, in SDK's van leveranciers en in externe infrastructuur, waar het begrip tenant niet bestaat tenzij je het zelf hebt bedacht.
De faalmodus is zelden dramatisch. Niemand wordt wakker met tenant A die de database van tenant B leest. Wat er gebeurt is kleiner en makkelijker te bouwen: een retrieval-helper voor de ene feature wordt hergebruikt in een andere, waar het tenantfilter anders wordt doorgegeven en stilletjes op niets valt. Een prompt-template cachet het blok recente voorbeelden over requests heen om tokens te sparen. Een wekelijkse samenvattingsjob loopt langs alle tenants en bouwt context op voordat de tenantscope vaststaat. Een support-engineer exporteert 200 traces om een hallucinatie te debuggen en elke trace bevat letterlijke klantcontent.
Geen van die dingen is een security-incident zoals in de film. Elk ervan is wel een bevinding die een deal stopzet, en minstens één ervan zit in de meeste AI-functies die wij hebben beoordeeld en die snel zijn gebouwd door een klein team onder druk.
Er is een tweede, subtieler probleem. Een model maakt geen onderscheid tussen instructies en data. Als tenant B tekst kan plaatsen op een plek die de request van tenant A leest, kan die tekst de output van tenant A sturen. Gedeelde kennisbanken, gedeelde voorbeeldpools en gedeelde few-shot-bibliotheken creëren allemaal dat pad. Dat is niet theoretisch: prompt injection en sensitive information disclosure zijn de twee hoogste posities in de OWASP Top 10 voor LLM-applicaties, en sensitive information disclosure klom in de editie van 2025 van plek 6 naar plek 2, juist omdat teams dit patroon bleven bouwen.
De 4 lekpaden die row-level security niet dekt
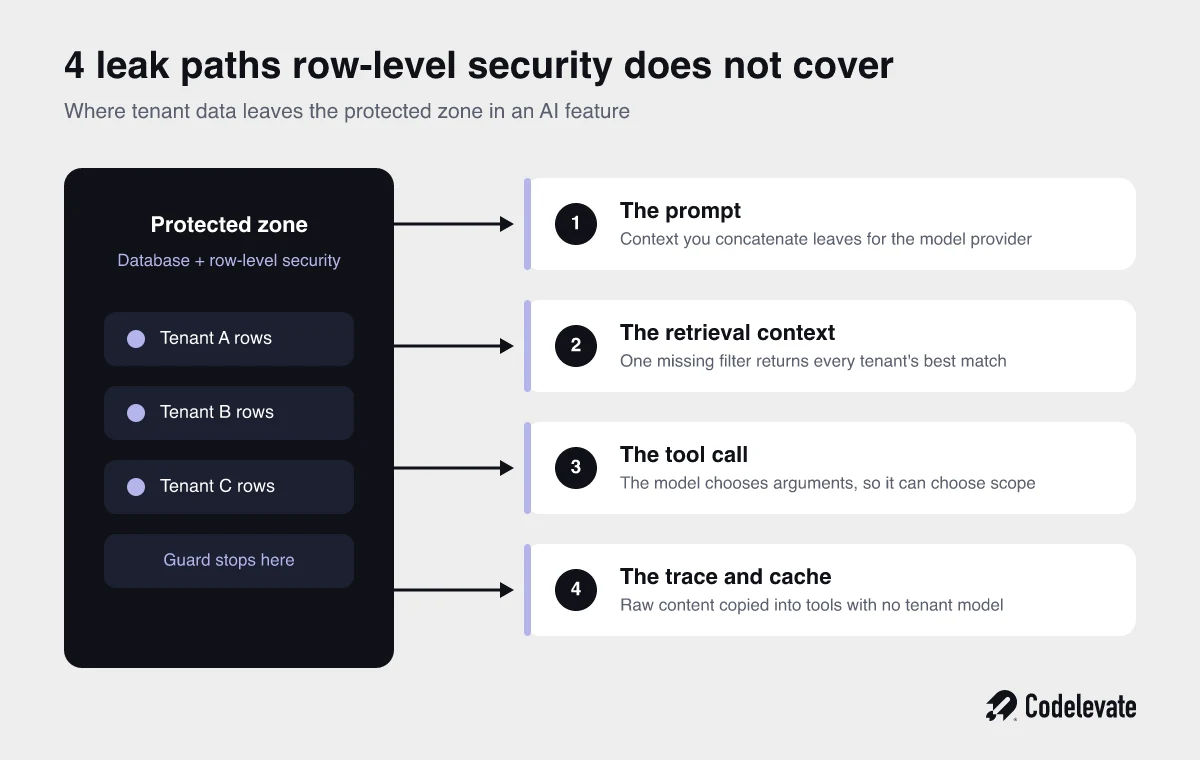
Zodra je accepteert dat de grens naar buiten moet, wordt het werk concreet. Er zijn 4 plekken waar tenantdata de beschermde zone verlaat. Breng ze in kaart en de security-vragenlijst is geen visexpeditie meer.
1. De prompt
De prompt is de eerste plek waar tenantdata je perimeter verlaat, en degene waarover teams het minst zorgvuldig nadenken, omdat het op string-concatenatie lijkt in plaats van op een datatransfer.
Alles wat je in de prompt zet gaat naar een modelleverancier: de system prompt, het gebruikersbericht en elk stuk context dat je hebt toegevoegd. Jouw databeschermingsverhaal is nu het databeschermingsverhaal van je leverancier, en je koper vraagt je dat te bewijzen. Dat betekent een getekende overeenkomst over trainingsgebruik, een vastgelegde bewaartermijn, een benoemde regio en een vermelding als subverwerker.
Het tenantspecifieke risico zit in hoe prompts worden opgebouwd. Templates die vergelijkbare eerdere gevallen ophalen zijn de boosdoener, want de nuttigste voorbeelden komen bijna altijd uit je hele corpus en niet uit één klant. Een patroon dat de outputkwaliteit 10 procent verbetert kan tenant A een zin uit tenant B geven. De oplossing is saai en effectief: elk stuk context draagt een expliciete tenant-tag, en de promptbouwer weigert een prompt met meer dan één tag.
2. De retrieval-context
Retrieval is het lekpad met de grootste impact, want één verkeerd filter levert de meest relevante content op van al je klanten, en dat is precies de content die je het minst wilt verplaatsen.
Vectordatabases zijn geen relationele databases, en de meeste hebben geen row-level security. Isolatie is een namespace, een index of een metadatafilter dat je meegeeft bij de query, dus die leeft in je querycode en niet in de opslagengine. Dat is een echte stap terug ten opzichte van je relationele laag, en het loont dat hardop te zeggen, want engineers die de database vertrouwen strekken dat instinctief uit naar de vectorstore.
Twee details worden vaak gemist. Ten eerste verwijdering. Als een tenant een record verwijdert of vertrekt, verdwijnt de bronrij en de embedding meestal niet, dus blijft je AI-functie antwoorden geven uit data waarvan de klant denkt dat die weg is. Onder de AVG is dat een verwijderverzoek dat je niet hebt uitgevoerd. Ten tweede herkomst. Komt een chunk zonder tenant-identificatie in je index terecht bij ingestie, dan kan geen enkel filter dat later herstellen en herindexeer je je hele corpus.
3. De tool call
Zodra je AI-functie stopt met samenvatten en begint met handelen, moet de tenant-grens zich uitstrekken tot elke tool die het model kan aanroepen, en het model kiest zelf de argumenten.
Hier worden AI-functies echt anders dan de rest van je product. Een agent die get_customer, send_email of update_record kan aanroepen, genereert die argumenten uit tekst, en tekst is beïnvloedbaar. Een supportticket met een instructie erin, een PDF met een verborgen regel of een CRM-notitie van een buitenstaander kan een tool call sturen. Vertrouwen je tools de argumenten van het model, dan bepaalt een taalmodel de tenantscope.
De maatregel is simpel te formuleren en makkelijk over te slaan. Tenantcontext komt uit de ingelogde sessie, nooit uit het model. Elke tool leidt de tenant opnieuw af uit de request-context en autoriseert het doelobject daar opnieuw tegen, zoals een goed gebouwd API-endpoint. Het model kiest welke tool wordt aangeroepen. Nooit wiens data.
4. De trace, de cache en de eval-set
Observability is het stilste lekpad, en het pad dat het vaakst ontbreekt op je architectuurplaat, omdat een goedbedoelende engineer het toevoegde tijdens het debuggen van een slecht antwoord.
Een LLM-functie is lastig te debuggen zonder de echte prompt en output te zien, dus vrijwel elk team stuurt volledige prompt- en completion-capture naar een tracing-tool. Die tool is meestal een extern SaaS-product, buiten je tenantmodel, vaak buiten je dataregio, en leesbaar voor elke engineer met een login. Je hebt stilletjes een tweede kopie van de gevoeligste klantcontent gebouwd, met zwakkere controles dan je database.
Hetzelfde geldt voor twee aangrenzende artefacten. Prompt- en semantische caches gebruiken content als sleutel, dus een cache die niet per tenant is gepartitioneerd kan de ene klant een antwoord serveren dat uit data van een andere klant komt. Eval-datasets zijn erger, want hun hele doel is duurzaamheid, en een golden set uit productieverkeer wordt een permanente export van echte klantgegevens.
Behandel alle drie als productiedatastores. Redigeer of tokeniseer vóór capture, partitioneer caches per tenant, houd eval-sets synthetisch of contractueel afgedekt, en zet een bewaartermijn op traces waar je in een vragenlijst naar kunt verwijzen.
Ben je dit werk nu aan het inplannen, dan behandelt onze SaaS founder's AI blueprint de architectuur- en volgordekeuzes achter AI-functies in een bestaand product, inclusief hoe je een build zo faseert dat securitywerk niet het laatste is wat je ontdekt. Gratis, en in ongeveer 20 minuten gelezen.
Silo, pool of hybride: een isolatiepatroon kiezen dat je kunt verdedigen
De kernkeuze in multi-tenant AI is hoe je tenants scheidt in de retrieval-laag, en er zijn precies 3 geloofwaardige antwoorden. Kies er bewust één, schrijf op waarom, en je hebt het grootste deel van je securityverhaal al staan.
Silo betekent dat elke tenant een eigen index, collectie of database-instantie krijgt. Niets wordt gedeeld, dus een ontbrekend filter levert niets op in plaats van andermans data. Het auditverhaal is één zin lang. De kosten zijn operationeel: honderden indexen om in te richten, te migreren en te monitoren, plus minimumtarieven per index die kleine tenants duur maken. De juiste standaard als tenants weinig, groot en gereguleerd zijn.
Pool betekent één gedeelde index met een tenant-identificatie op elke vector, gefilterd bij de query. Fors goedkoper, schaalt naar duizenden tenants zonder operationele pijn, en maakt analyses over tenants heen mogelijk. Het legt ook de hele grens in je querycode, precies waar dit artikel voor waarschuwt. Pool is verdedigbaar, maar alleen met één afgedwongen toegangslaag die geen feature kan omzeilen, plus tests die isolatie op elk codepad controleren.
Hybride is waar de meeste volwassen producten uitkomen. Standaard pool, silo voor de tenants wier contracten of toezichthouders dat eisen, met één interface voor beide zodat featurecode niet weet waarmee die praat. Het kost eenmalig meer en bespaart je het herprijzen van je architectuur zodra een grote klant om eigen opslag vraagt.
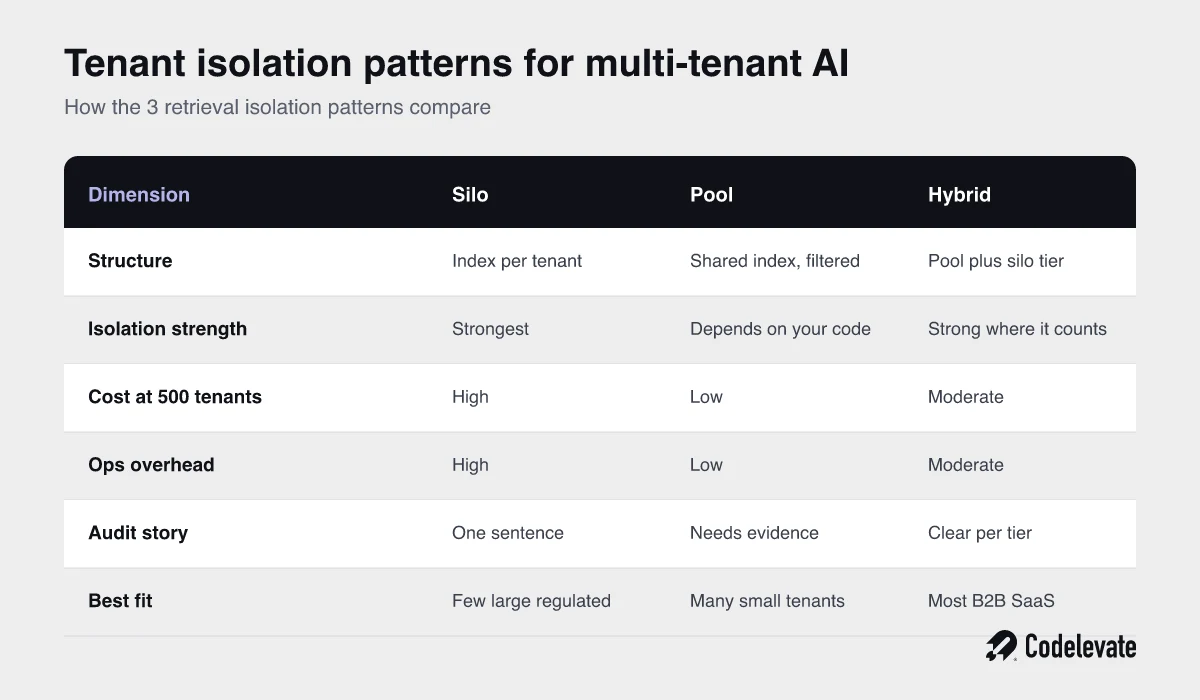
De fout die je wilt vermijden is per ongeluk in pool belanden. Genoeg teams kiezen een gedeelde index omdat dat de standaard was in een quickstart, leggen de keuze nooit vast, en kunnen dan niet beantwoorden hoe tenantdata in hun vectorstore gescheiden is zonder een week code te lezen. Het patroon telt minder zwaar dan het kunnen uitleggen ervan.
De 6 maatregelen die een review doorstaan
Dit zijn de maatregelen die contact met een enterprise securityteam consequent overleven. Ze zijn niet exotisch, en geen ervan vraagt om een herbouw van je platform.
• Eén tenant-scoped datatoegangslaag. Elke read die een prompt kan bereiken loopt via één module die tenantcontext als verplicht argument neemt en niet zonder aangeroepen kan worden. Geen enkele feature krijgt zijn eigen retrieval-helper.
• Tenantcontext uit de sessie, nooit uit het model. Leid hem af aan de rand, draag hem mee in de request-context, en leid hem opnieuw af in elke tool en elke achtergrondjob voordat er data wordt aangeraakt.
• Tenant-tags bij ingestie, niet bij de query. Elke chunk, embedding en cachesleutel draagt een tenant-identificatie die bij het aanmaken wordt geschreven. Filteren bij de query is de tweede verdedigingslinie, niet de eerste.
• Isolatietests als permanente suite. Een test die 2 tenants opzet, elk AI-codepad als tenant A draait, en controleert dat er nergens content van tenant B opduikt in de prompt, de response of de trace. Draai hem in CI en je hebt een echt antwoord in een vragenlijst.
• Redactie vóór observability. Traces leggen standaard structuur, tokenaantallen, latency en identificaties vast. Ruwe content vastleggen is opt-in, in tijd begrensd en gelogd.
• Een verwijderpad dat tot in de AI-laag reikt. Wordt een record verwijderd of vertrekt een tenant, dan verdwijnen embeddings, gecachte antwoorden en traces op hetzelfde schema als de bronrij, en kun je dat aantonen.
Wat multi-tenant AI echt kost, en waar teams te veel bouwen
Het eerlijke antwoord is dat dit goed doen ergens tussen 3 en 6 weken engineering toevoegt aan een eerste AI-functie in een bestaand multi-tenant product, en bijna niets aan de tweede. Die asymmetrie is het hele punt.
Het meeste daarvan is eenmalig platformwerk: de toegangslaag, de tenant-bewuste retrieval-interface, ingestie-tagging, het isolatietestharnas en redactie in observability. Bouw het één keer en elke latere AI-functie erft het. Sla het over en je betaalt een kleinere belasting in elke feature, voor altijd, plus één grote onvoorziene rekening zodra het securityteam van een koper je architectuur leest.
De doorlopende kosten vallen mee. Gepoolde vectoropslag bij een paar honderd tenants is zelden de grootste post; inference wel. Wat mensen verrast is kostentoerekening per tenant. Kun je niet zeggen wat het AI-gebruik van één klant kost, dan kun je de feature niet prijzen, niet zien welke tenant met 2 power users 40 procent van je tokenbudget opsoupeert, en geen fair-use-limiet handhaven. Tag elke modelaanroep vanaf dag één met een tenant-identificatie. Dat kost niets vooraf en is pijnlijk om achteraf te doen.
Waar teams te veel bouwen is even voorspelbaar. Een eigen model-deployment per tenant waar niemand om vroeg is de duurste fout die er is, en lost iets op dat gepoolde inference met goede request-isolatie al oplost. Fine-tunen per tenant is de tweede, want dat maakt een permanente, moeilijk te verwijderen kopie van klantdata in modelgewichten en verandert een verwijderverzoek in een hertrainingsproject. Geen van beide is nodig voor de meeste B2B SaaS-producten. Grijp ernaar als een contract het eist, niet als een plaatje er netter van wordt.
Je echte deadline is de eerste security-vragenlijst
Dit is de commerciële herkadering die verandert hoe teams dit werk plannen. De deadline voor multi-tenant AI is niet je releasedatum. Het is de eerste enterprise security-vragenlijst die terugkomt met een AI-sectie erin, en die komt precies wanneer de deal het dichtst bij tekenen is.
Het patroon is pijnlijk consistent. Een mid-market- of enterprise-koper kiest voor je, inkoop start, en de vragenlijst landt. Er wordt gevraagd welke modelleverancier je gebruikt, of prompts voor training worden gebruikt, waar inference plaatsvindt, hoe tenantdata in retrieval gescheiden is, hoe lang prompts en completions bewaard blijven, en of het model op klantdata kan handelen. Volgens het G2 2026 Buyer Behavior Report is de IT-securityreview de grootste vertragingsbron tussen het kiezen van een leverancier en het afronden van de aankoop, genoemd door 39 procent van alle kopers en de helft van de enterprise-kopers. Die vragen zijn geen formaliteit. Ze zijn de poort.
Een team dat de grens bewust heeft gebouwd, antwoordt in een middag, met een plaat, een testsuite en een lijst subverwerkers. Een team dat eerst de feature bouwde, is 3 tot 6 weken bezig met forensische archeologie op de eigen code, terwijl de interne pleitbezorger bij de klant zijn momentum verliest. Zelfde product, zelfde kwaliteit AI-functie, compleet ander kwartaal.
Daarom behandelen wij de vragenlijst als ontwerpinput en niet als compliance-klusje. Schrijf de antwoorden voordat je de feature schrijft. Kun je niet in 3 zinnen uitleggen hoe tenantdata in elke laag van deze feature gescheiden is, dan is de architectuur nog niet af.
Een uitgewerkt voorbeeld: AI-samenvattingen in een SaaS met 400 tenants
Neem een concrete situatie. Een B2B-operationsplatform, 400 klantorganisaties, Postgres met row-level security, ruwweg 40 miljoen records, verkopend in mid-market met de eerste enterprise-deals in zicht. Het team wil een AI-samenvatting op elk project, uit notities, documenten en activiteitenhistorie.
De naïeve build kost ongeveer 3 weken. Haal het project en de bijbehorende records op, embed de documenten in een gedeelde vectorindex, haal bij elk verzoek de 20 beste chunks op, bouw een prompt, roep een model aan, cache op project-ID, en stuur volledige traces naar een observability-tool. Het werkt, het demo't prachtig, en het bevat minstens 3 van de 4 lekpaden hierboven.
Retrieval filtert op project-ID in plaats van tenant-ID, wat prima gaat tot 2 tenants projecten met botsende identifiers hebben of een helper zonder filter wordt hergebruikt. De cache gebruikt content als sleutel, dus 2 tenants met vergelijkbare documenten kunnen een gecachet antwoord delen. Traces dragen ruwe klantnotities naar een externe tool zonder bewaarbeleid. Er is nog niets misgegaan, en er gaat ook niets mis, tot de dag dat het wel gebeurt of tot iemand het vraagt.
De bewuste build kost ongeveer 6 weken en verschilt op vooral onspectaculaire manieren. Ingestie schrijft een tenant-identificatie op elke chunk. Retrieval loopt via één interface die tenantcontext vereist en eerst op tenant filtert, dan op project. De cachesleutel bevat de tenant-identificatie. Tool calls, zodra samenvattingen een agent worden die records kan bijwerken, leiden de tenantscope opnieuw af uit de sessie. Traces leggen standaard tokenaantallen en identificaties vast, met een venster van 7 dagen en contentcapture achter een vlag. Een isolatietest zet 2 tenants op en controleert dat tenant A nooit content van tenant B ziet.
Drie weken extra. Daarvoor ship je de tweede AI-functie in een week in plaats van drie, beantwoord je de security-vragenlijst vanuit documentatie in plaats van een code-audit, en wordt een grote klant die om eigen opslag vraagt een configuratiewijziging in plaats van een herbouw. Die afweging is niet spannend.
Hoe wij multi-tenant AI-builds aanpakken
Als wij AI-werk oppakken binnen een bestaand SaaS-product, is het eerste artefact geen prototype. Het is een datastroom van één pagina die volgt waar tenantdata langsgaat, van de database via retrieval, prompt, model, response, cache en trace, met de grens erop getekend. Dat kost een halve dag en vindt consequent 1 of 2 paden waar het team niet aan dacht.
Daarna is de volgorde platform eerst, feature daarna: de tenant-scoped toegangslaag en ingestie-tagging gaan erin voordat er één modelaanroep is geschreven, want die achteraf inbouwen betekent je corpus opnieuw verwerken. We schrijven de antwoorden op de security-vragenlijst naast de architectuur, en dat is de goedkoopste manier die we kennen om een build eerlijk te houden.
Die aanpak komt voort uit het bouwen van productieplatformen, niet van demo's. Wil je een tweede paar ogen op een build die al loopt, dan beoordeelt ons AI-developmentteam bestaande AI-architecturen als een opdracht met vaste scope, en dekt ons SaaS-developmentwerk de platformlaag eronder.
De cirkel rond
Multi-tenant AI komt neer op één idee: je tenant-grens moet naar buiten opschuiven en de prompt, de retrieval-context, de tool call en de trace omvatten, want de databasebewaker die je al vertrouwt stopt bij de query. Doe dat werk vooraf en AI-functies worden een normaal onderdeel van je roadmap. Sla het over en elke enterprise-deal betaalt ervoor in vertraging.
Het doel is geen slimmer product. Het is een product waarbij een AI-functie toevoegen geen brandoefening wordt, waarbij de security-vragenlijst wordt beantwoord vanuit een document dat je al hebt geschreven, en waarbij de architectuur standhoudt als een klant die 10 keer groter is dan je grootste vraagt hoe het werkt.
Wil je het bredere architectuur- en volgordebeeld, dan is de SaaS founder's AI blueprint een gratis download over het faseren van AI in een bestaand product zonder het te herbouwen.
En ga je AI toevoegen aan een product dat al data van anderen bevat, dan is een uur met iemand die deze grens eerder heeft getekend het waard. Je kunt een gratis gesprek met ons team inplannen en dan lopen we je datastroom samen door.