AI kennisbank opzetten: wat je AI eerst moet kunnen lezen
Je hebt al een kennisbank. Hij zit in de hoofden van 3 mensen, in 5 mappen op de schijf en in een paar mails die niemand meer terugvindt. Wie zoekt op "AI kennisbank opzetten", krijgt vooral lijstjes met tools. Het echte werk zit ergens anders: je kennis zo opschrijven dat een AI er iets mee kan doen, en niet alleen iets in kan zoeken.
Dat verschil bepaalt of je AI straks een dossier voorbereidt zoals je beste adviseur het zou doen, of zoals een gemiddelde van 5 adviseurs die het elk op hun eigen manier doen.
Dit artikel is voor de eigenaar, managing partner of operationeel leider van een Nederlands B2B dienstverlenend bedrijf met 10 tot 200 mensen. Je doet een herhaalbaar expertproces met de hand, je rekent per stuk of per uur, er zit volume in, en de kennis die dat proces draait zit bij een paar mensen. Denk aan subsidieadviseurs, BPM en douanespecialisten, certificeerders, compliance adviseurs, administratiekantoren en keuringsbedrijven.
Het is niet voor je als je een helpdesk wilt met een chatbot voor klantvragen, als je nog in de ideefase zit, of als je 1 slimme zoekfunctie over je SharePoint zoekt. Daar zijn goede kant en klare tools voor, en die hebben dit artikel niet nodig.
In dit artikel lees je waarom een kennisbank voor mensen iets anders is dan een kennisbank voor AI, uit welke 6 lagen een AI kennisbank bestaat, hoe je er 1 opzet in 6 stappen, hoe dat uitpakt bij een subsidieadvieskantoor van 18 mensen, en waar het meestal misgaat.
Belangrijkste inzichten
• Een kennisbank voor mensen helpt zoeken. Een AI kennisbank moet helpen beslissen: regels, uitzonderingen en voorbeelden, niet alleen documenten.
• AI op een rommelige schijf herhaalt de rommel. Als 5 adviseurs het op 5 manieren doen, leest de AI 5 versies en kiest er 1, zonder te zeggen welke.
• Een AI kennisbank heeft 6 lagen: bronnen met een versiedatum, je eigen beslisregels, uitgewerkte dossiers, uitzonderingen, sjablonen en een eigenaar per regel.
• De meeste waarde zit in de laag die bijna niemand opschrijft: de uitzonderingen die alleen je meest ervaren collega kent.
• 40 tot 50 oude dossiers met de uitkomst erbij zijn je toets. Zonder die set weet je niet of de AI het goed doet, je hebt alleen een indruk.
• De tool is de minst belangrijke keuze. De vorm, de eigenaar en de plek (jouw accounts, exporteerbaar, EU) bepalen of het over 2 jaar nog werkt.
• Een kennisbank is geen project met een einddatum. Regels veranderen elk jaar, dus iemand moet hem bijhouden, met een naam en een datum.
Een kennisbank voor mensen is iets anders dan een kennisbank voor AI
Bijna elke gids over een AI kennisbank beschrijft hetzelfde: verzamel je documenten, zet ze in een tool, en laat medewerkers of klanten er vragen aan stellen. Dat is een zoekmachine met een chatvenster. Voor een helpdesk werkt dat prima. Een medewerker leest het antwoord, denkt even na en past het toe.
Voor een expertproces is dat niet genoeg. Stel dat je AI een subsidieaanvraag moet voorbereiden, een BPM berekening moet controleren of een certificeringsdossier moet beoordelen. Dan zoekt de AI niet naar een document. Hij moet een beslissing nemen: past deze klant binnen de regeling, welke kosten tellen mee, wat is het risico dat het wordt afgewezen.
Een document vertelt wat de regeling zegt. Een beslissing vraagt wat jullie ermee doen. Die 2 liggen verder uit elkaar dan je denkt. De regeling zegt dat kosten "direct toerekenbaar" moeten zijn. Jullie weten dat een bepaalde uitvoeringsinstantie daar streng in is, dat 1 soort advieskosten er in de praktijk nooit door komt, en dat je bij een starter altijd eerst de jaarrekening opvraagt.
Die kennis staat nergens. Ze zit in het hoofd van je senior. Een kennisbank voor AI begint dus niet bij het uploaden van documenten, maar bij het opschrijven van wat jullie doen met die documenten.
Waarom AI op een rommelige schijf de rommel herhaalt
We zagen het bij een subsidieadvieskantoor: 5 adviseurs werkten op 5 manieren in 5 tools. Iedereen had een eigen sjabloon, een eigen checklist en een eigen map met "goede voorbeelden". Allemaal verdedigbaar. Geen 2 hetzelfde.
Zet daar een AI op en er gebeurt iets vervelends. Het model leest alle 5 de versies en maakt er 1 antwoord van. Soms kiest het de strengste interpretatie, soms de soepelste, soms een mengvorm die niemand zou kiezen. Het zegt er niet bij welke versie het gebruikte. Het antwoord klinkt even zeker als altijd.
Dat is geen fout van het model. Het doet precies wat je vraagt: een antwoord geven op basis van wat het leest. Als wat het leest elkaar tegenspreekt, krijg je een gemiddelde. En in een expertproces is een gemiddelde van 5 goede adviseurs vaak slechter dan 1 van hen.
Er is nog een tweede probleem: oude versies. Op bijna elke schijf staan 3 versies van dezelfde regeling, van 2024, 2025 en 2026. Een mens ziet aan de mapnaam welke geldt. Een AI ziet 3 teksten die bijna hetzelfde zeggen, en pakt soms de verkeerde. Zonder versiedatum weet hij niet eens dat er een verkeerde is.
Dit is ook waarom zoveel bedrijven blijven hangen bij losse AI tools. Volgens het CBS gebruikte in 2025 27% van de bedrijven met 10 tot 50 werkzame personen AI, tegen 66% van de bedrijven met 250 of meer. Een groot deel van dat gebruik is persoonlijk: iemand die een mail laat herschrijven. De stap naar een proces dat de AI draagt, vraagt om kennis die op 1 plek staat en maar 1 keer.
De 6 lagen van een AI kennisbank
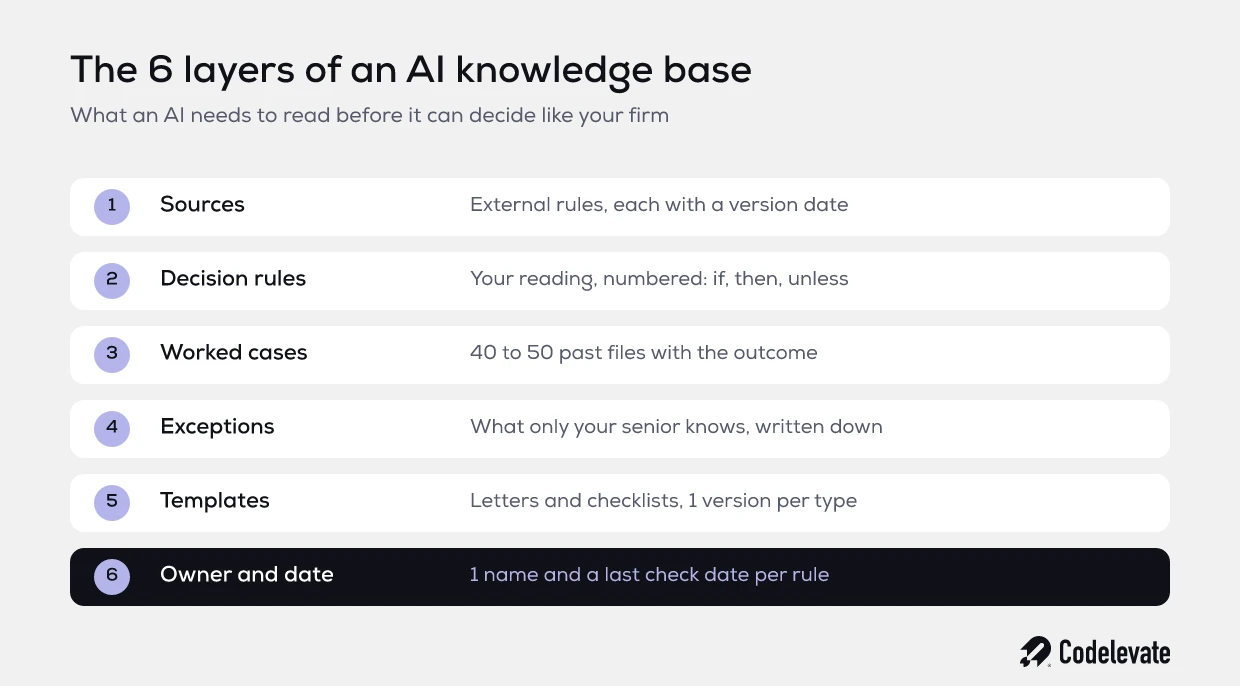
Een kennisbank waar een AI op kan werken, heeft 6 lagen. Je hebt ze niet allemaal op dag 1 nodig, maar je moet weten welke je mist.
1. Bronnen, met een versiedatum
De externe regels waar je proces op draait: de tekst van de regeling, de wet, de tarieftabel, de norm. Elke bron krijgt een datum waarop hij geldt en een datum waarop iemand hem voor het laatst controleerde. Oude versies gaan naar een archief waar de AI niet in kijkt.
2. Jullie beslisregels
Hoe jullie de bronnen toepassen, geschreven als regels en niet als verhaal. "Als de klant korter dan 3 jaar bestaat, dan vragen we eerst de jaarrekening op, tenzij er een accountantsverklaring ligt." Elke regel krijgt een nummer, zodat je later kunt zien welke regel de AI gebruikte.
Dit is de laag waar de meeste discussie ontstaat, en dat is goed. Als 2 adviseurs het oneens zijn over een regel, heb je net een verschil gevonden dat je klanten nu ook al merken.
3. Uitgewerkte dossiers
40 tot 50 echte, oude dossiers met de input, de beslissing en de uitkomst. Is de aanvraag toegekend, afgewezen of aangepast? Waarom? Deze set heeft 2 functies. De AI leert ervan hoe jullie denken, en jij gebruikt hem als toets om te meten of de AI het goed doet.
Kies ook de lastige dossiers, niet alleen de nette. Juist de 5 dossiers waar iedereen over twijfelde, laten zien waar de grens ligt.
4. Uitzonderingen
Alles wat begint met "behalve als". De uitvoeringsinstantie die altijd om een extra bijlage vraagt. De sector waar een standaardberekening niet klopt. De klant die al 3 keer is afgewezen. Deze laag komt vrijwel altijd uit 1 of 2 hoofden, en het is de laag die het meest waard is.
5. Sjablonen en vaste formuleringen
De brieven, rapporten, checklists en vaste zinnen in jullie huisstijl, 1 versie per soort. Als de AI een conceptaanvraag schrijft, moet die eruitzien alsof jullie hem schreven, niet alsof een model hem schreef.
6. Eigenaar en datum
Elke regel, bron en uitzondering krijgt 1 naam en een datum van de laatste controle. Niet "het team", maar een persoon. Zonder eigenaar veroudert een kennisbank in ongeveer een jaar, en een verouderde kennisbank is gevaarlijker dan geen kennisbank, omdat de AI hem blijft geloven.
Wil je dit op 1 plek uitwerken?
De gratis AI product requirements template helpt je je proces, je regels en je volumes op 1 plek te zetten voordat je iets laat bouwen. Handig als startpunt voor laag 1 tot en met 3, en je kunt er elke offerte mee vergelijken.
Zo zet je een AI kennisbank op in 6 stappen
Je hoeft niet je hele bedrijf in kaart te brengen. Begin met 1 proces en maak dat af. Dat gaat sneller dan je denkt, en het vertelt je meer dan een plan voor alles.
Stap 1: kies 1 proces met volume
Kies het proces dat het vaakst terugkomt en waar een prijs op staat: de aanvraag, de berekening, het dossier. Hoe vaker het voorkomt, hoe sneller de kennisbank zich terugbetaalt, en hoe meer oude dossiers je hebt om te toetsen.
Stap 2: verzamel alle versies die nu in gebruik zijn
Vraag elke medewerker die het proces doet om de sjablonen, checklists en voorbeelden die ze echt gebruiken. Niet de officiële versie uit de map, maar die van hun bureaublad. Leg ze naast elkaar. De verschillen zijn je eerste werklijst.
Stap 3: schrijf de regels uit met je meest ervaren collega
Plan 3 tot 5 sessies van 2 uur met de persoon die het proces het best kent. Loop samen 10 dossiers door en vraag bij elke stap: waarom doe je dit, en wanneer doe je het anders? Schrijf elk antwoord op als regel of uitzondering. Iemand anders schrijft mee, zodat je senior kan blijven praten.
Stap 4: verzamel 40 tot 50 dossiers met uitkomst
Haal oude dossiers op waarvan je weet hoe het afliep. Anonimiseer de klantgegevens. Noteer per dossier de uitkomst en 1 zin met de reden. Staat de uitkomst nergens vastgelegd, dan kost dit 2 middagen met de adviseur. Die middagen zijn het meest waardevolle deel van het hele traject.
Stap 5: laat de AI de dossiers beoordelen, en tel
Geef een AI alleen de kennisbank en laat hem de 40 tot 50 dossiers beoordelen zonder de uitkomst te zien. Vergelijk zijn antwoord met wat er echt gebeurde. Tel de fouten en kijk per fout waarom: een ontbrekende regel, een uitzondering die niet was opgeschreven, of 2 regels die elkaar tegenspreken. Elke fout is een gat in je kennisbank, niet in de AI.
Stap 6: wijs eigenaren aan en zet een ritme
Elke regel krijgt een eigenaar. Spreek af wanneer je controleert: bij elke wijziging van de regeling, en minimaal elk kwartaal. Draai daarna de toets uit stap 5 opnieuw. Als de score daalt, is er iets veranderd dat nog niet in de kennisbank staat.
Een rekenvoorbeeld: een subsidieadvieskantoor van 18 mensen
Een voorbeeld, geen klant. Neem een kantoor met 18 mensen, waarvan 6 adviseurs. Ze dienen per jaar 300 aanvragen in voor 3 regelingen. Een aanvraag kost gemiddeld 8 uur. De uurkosten van een adviseur liggen rond 80 euro, alles meegerekend.
Van die 8 uur gaat ongeveer 1,5 uur op aan zoeken en afstemmen: welke versie van de regeling geldt, hoe deden we dit vorige keer, waar staat het goede sjabloon, en even bij de senior langs. Dat is 450 uur per jaar, ofwel 36.000 euro. Daarbovenop gaat 1 op de 5 aanvragen intern terug voor een tweede ronde omdat iets niet klopt met hoe een collega het zou doen. Dat is nog eens 60 uur, of 4.800 euro.
Samen zit er zo'n 40.800 euro per jaar in kennis die niet is opgeschreven. En dat is voordat er 1 regel is geautomatiseerd.
Het opzetten van de kennisbank voor die 3 regelingen kost vooral interne tijd: 50 uur van de senior adviseur, 20 uur van 2 andere adviseurs, en 10 uur van de office manager voor het verzamelen van dossiers. Samen 100 uur, of 8.000 euro. Na 6 weken ligt er een kennisbank met 120 regels, 45 uitgewerkte dossiers, 14 uitzonderingen, 9 sjablonen en een eigenaar per regeling.
Dan de toets. In de eerste ronde beoordeelt de AI 31 van de 45 dossiers goed. 9 fouten komen door uitzonderingen die nog niet waren opgeschreven, 5 door regels die elkaar tegenspraken. Na 2 middagen bijwerken beoordeelt hij 41 van de 45 goed. De laatste 4 zijn echte twijfelgevallen, en daar kijkt voortaan altijd een adviseur naar.
Wat levert het op? Ook zonder automatisering daalt de zoektijd, omdat adviseurs een assistent hebben die in 1 bron zoekt. Stel dat 1,5 uur per aanvraag 0,5 uur wordt: dat scheelt 300 uur, of 24.000 euro per jaar. De interne investering van 8.000 euro is dan in ongeveer 4 maanden terug. Voor de rest is het een fundament: de automatisering van het aanvraagconcept die daarna komt, leest precies deze kennisbank.
Het omgekeerde geldt ook. Doet je kantoor 40 aanvragen per jaar en is er 1 adviseur, dan is een goede werkinstructie in 1 document genoeg. Een kennisbank met 6 lagen is dan te veel gereedschap voor te weinig werk.
Waar het meestal misgaat
We zien steeds dezelfde 6 fouten. Ze kosten allemaal maanden, en ze zijn allemaal te voorkomen.
• Alles uploaden. De hele schijf in een tool zetten geeft de AI meer tegenspraak, niet meer kennis. Minder bronnen die kloppen werken beter dan alles wat er is.
• Geen versiedatum. De AI weet niet welke regeling geldt, en jij weet niet welke hij gebruikte.
• Regels als verhaal. Een werkinstructie van 12 pagina's proza is voor een AI moeilijker toe te passen dan 40 genummerde regels met uitzonderingen.
• Geen toetsset. Zonder oude dossiers met uitkomst beoordeel je de AI op gevoel, en elke discussie wordt een mening tegen een mening.
• Geen eigenaar. Na 1 jaar zijn 3 regelingen gewijzigd en weet niemand welke regels nog kloppen.
• De kennisbank in een tool die je niet kunt exporteren. Dan is je belangrijkste bezit afhankelijk van het prijsbeleid van een leverancier.
Welke tool, en waar je kennisbank moet staan
De vraag die je het eerst stelt, is de minst belangrijke. Een kennisbank in goed geordende documenten en 1 spreadsheet met regels werkt beter dan een dure tool vol rommel. Begin met de vorm, kies daarna het gereedschap.
Voor een eerste toets is een project in ChatGPT of Claude prima. Zet er je regels, uitzonderingen en 20 dossiers in en stel je eigen vragen. Je ziet binnen een middag waar de gaten zitten. Voor een proces dat echt draait, heb je meer nodig.
Een AI die een kennisbank leest, werkt meestal met een techniek die retrieval heet: bij elke vraag zoekt het systeem eerst de relevante regels en dossiers op, en geeft die aan het model. Het model beslist dan op basis van jouw tekst, niet op basis van wat het ooit op internet las. Hoe beter je regels geordend en genummerd zijn, hoe beter dat opzoeken werkt. Wil je weten waarom dat zo zwaar weegt, lees dan ons stuk over context engineering voor AI agents.
Waar je ook voor kiest, stel 4 eisen:
• De kennisbank staat in jouw accounts, niet in die van de bouwer.
• Je kunt alles exporteren als gewone bestanden, op elk moment.
• De gegevens blijven in de EU en worden niet gebruikt om modellen te trainen.
• Klantdossiers en regels staan apart. De kennisbank bevat regels en geanonimiseerde voorbeelden. Klantgegevens blijven in je dossiersysteem, met de rechten die daar al gelden.
Die laatste eis maakt het AVG verhaal een stuk eenvoudiger. De AI leest jullie kennis, en krijgt per dossier alleen de gegevens van die ene klant.
Van kennisbank naar automatisering
Een kennisbank is geen doel op zich. Het is de laag waar elke automatisering daarna op leest. Wie direct een AI laat bouwen die aanvragen voorbereidt, bouwt die kennisbank alsnog, alleen dan verstopt in prompts en code, waar je senior hem niet kan lezen of controleren.
Daarom zetten wij hem apart en vooraan. Als de kennisbank goed is, wordt de automatisering kleiner, goedkoper en beter te testen. Als een regeling verandert, pas je 1 regel aan in plaats van een stuk software. En je hebt iets dat blijft als een ervaren collega vertrekt.
Of je data verder klaar is voor een AI die zelf handelt, check je per proces. Ons artikel over datagereedheid voor AI agents geeft daar 7 controles voor.
Zelf doen, iemand aannemen of laten bouwen
Een groot deel van dit artikel kun je zelf doen. Stap 1 tot en met 4 vragen vooral tijd van je eigen mensen, geen engineer. Heb je een office manager of adviseur die van structuur houdt, begin dan daar.
Iemand aannemen loont zelden alleen voor de kennisbank. Een senior developer in Nederland kost 85.000 tot 125.000 euro per jaar, alles meegerekend, en het vinden duurt 2 tot 4 maanden. Voor een fundament van 6 tot 8 weken is dat te veel. Wordt het een reeks automatiseringen en later een platform, dan kan het wel.
Laat je het bouwen, stel dan de 3 vragen die elk verstandig bedrijf stelt.
Wie werkt eraan? Bij ons 2 engineers bij naam, samen met je meest ervaren collega, want die kent de regels.
Wat gebeurt er na de oplevering? Elke regel heeft een eigenaar aan jouw kant. De engineer houdt bij hoe de AI de kennisbank leest en past dat aan als modellen veranderen. De afspraken over reactietijd en kosten voor Maand 4: vastgesteld in de Blueprint.
Wat als maand 1 tegenvalt? Dan stop je. Exit na maand 1: je betaalt wat er geleverd is en houdt alles.
Hoe wij dit aanpakken
Codelevate maakt van Nederlandse B2B dienstverleners softwarebedrijven: we brengen het expertproces in kaart dat je nu met de hand doet, automatiseren het zodat hetzelfde team het volume aankan, en bouwen het platform waar je klanten voor betalen, met 2 engineers bij naam van de blueprint tot jaar 2.
De kennisbank is bij ons de Foundation: 1 bron van waarheid waar je bedrijf en je AI op draaien, in jouw accounts. Hij volgt op de Blueprint, waarin we in 10 tot 20 werkdagen je proces in kaart brengen zoals het echt loopt, de knelpunten prijzen in uren en euro's, en een roadmap maken met vaste prijzen per mijlpaal. De Blueprint kost 2.500 tot 10.000 euro, afhankelijk van het aantal processen. De Foundation duurt 4 tot 8 weken, voor een vaste prijs uit de Blueprint.
Een voorbeeld van waar dat op uitkomt: een subsidiematcher waar een expert uren zocht, vindt nu in seconden de passende regelingen. Dat werkt alleen omdat de regels eerst op 1 plek stonden.
Wat je deze maand kunt doen
• Kies 1 proces met volume en een prijs per stuk.
• Vraag 3 collega's om het sjabloon en de checklist die ze echt gebruiken, en leg ze naast elkaar.
• Plan 2 sessies met je meest ervaren collega en schrijf 20 regels en 5 uitzonderingen uit.
• Zoek 20 oude dossiers op waarvan je de uitkomst kent.
• Zet het in een AI project en laat hem de 20 dossiers beoordelen. Tel de fouten.
Na die maand weet je hoe groot het gat is tussen wat er in de hoofden zit en wat er op papier staat. Dat getal is de beste start voor elk gesprek over AI in je bedrijf.
Wil je je proces, regels en volumes eerst netjes op een rij? Gebruik de gratis AI product requirements template.
Stuur wat je hebt
Een werkinstructie, een checklist, een map met sjablonen of een spreadsheet met je volumes: stuur wat je hebt. 1 van de 2 engineers leest het in 20 minuten met je door, en je krijgt dezelfde dag 1 van 3 antwoorden op papier: zelf doen, iemand aannemen, of de Blueprint.